Последнее поколение открытых больших языковых моделей демонстрирует впечатляющие результаты. Появился новый класс систем, которые по своим возможностям практически не уступают передовым облачным разработкам. Недавно Moonshot AI выпустила модели Kimi с высокими бенчмарками, за ней последовали DeepSeek с V4 Pro и Alibaba с Qwen 3.8. Именно Qwen 3.8 привлекает наибольшее внимание, поскольку эта модель поставляется с официальным весом 27B, который свободно помещается на потребительской видеокарте вроде RTX 3090.

Современные локальные языковые модели перешли на новый уровень эффективности, позволяя делегировать им серьезные задачи. Ранее локальные конфигурации использовались преимущественно для простых и высокообъемных процессов с жестким выводом JSON, но появление Qwen 3.8 27B кардинально меняет подход к работе с искусственным интеллектом.
Тестирование возможностей локальной модели Qwen 3.8
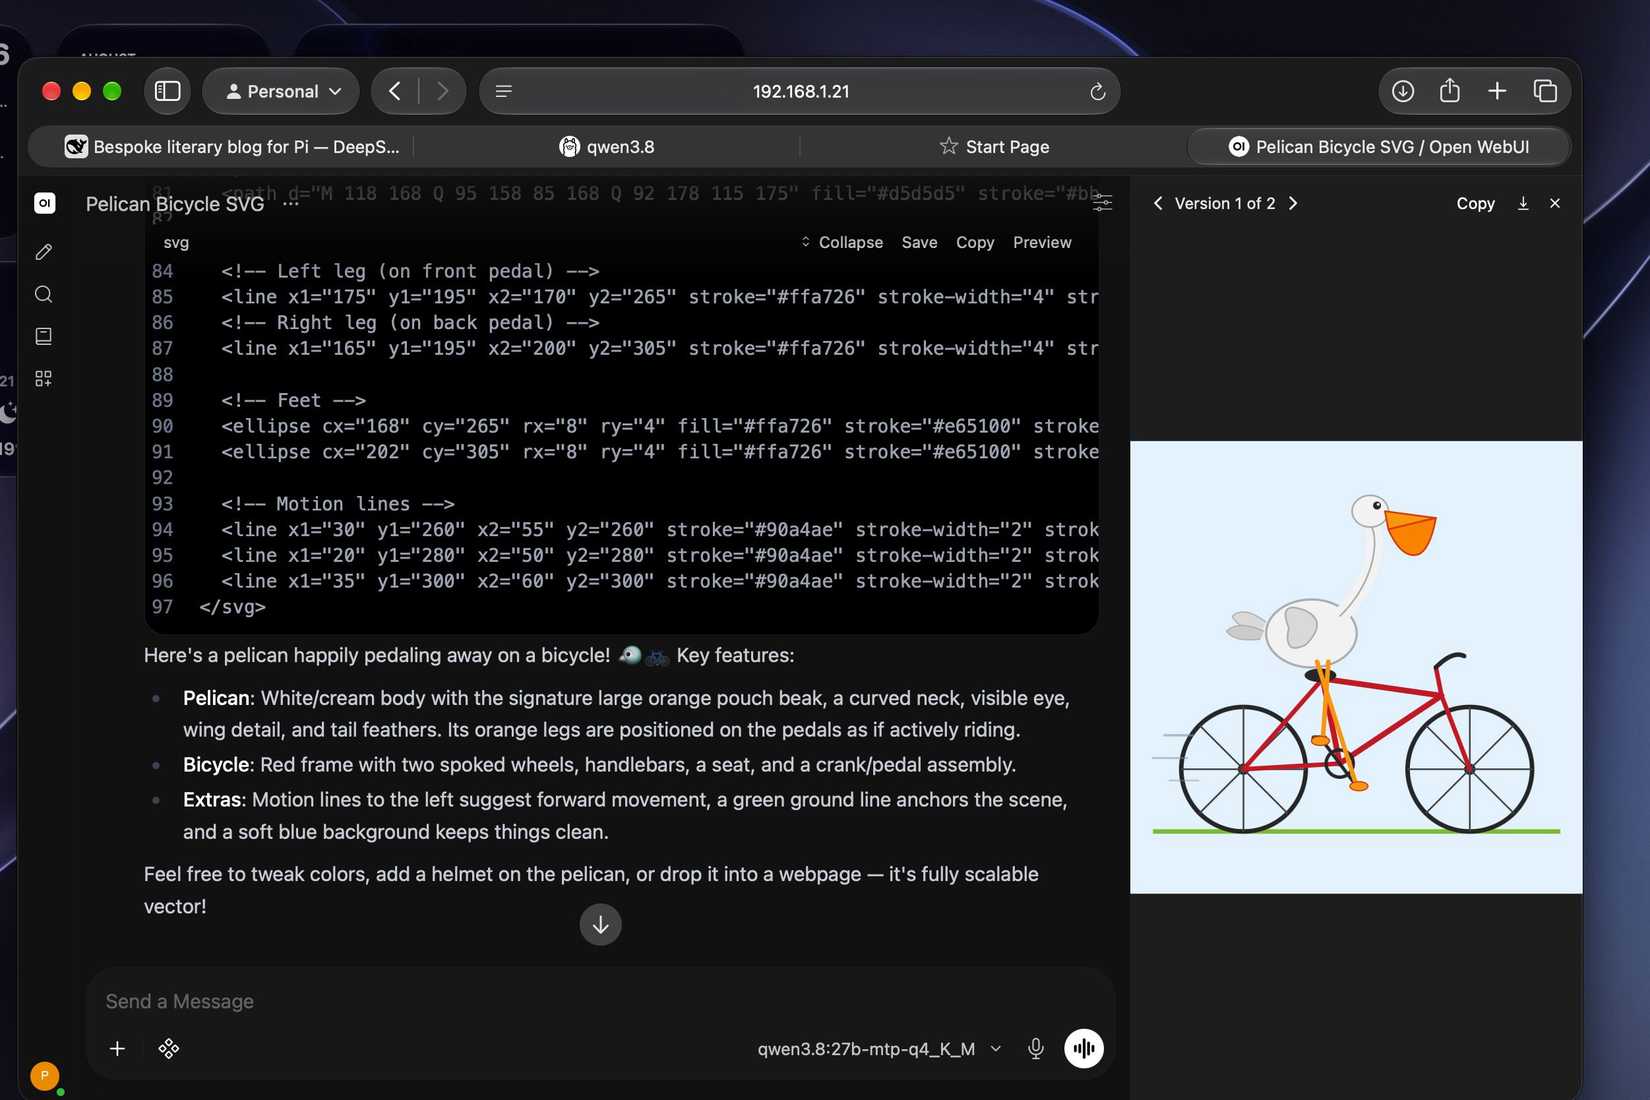
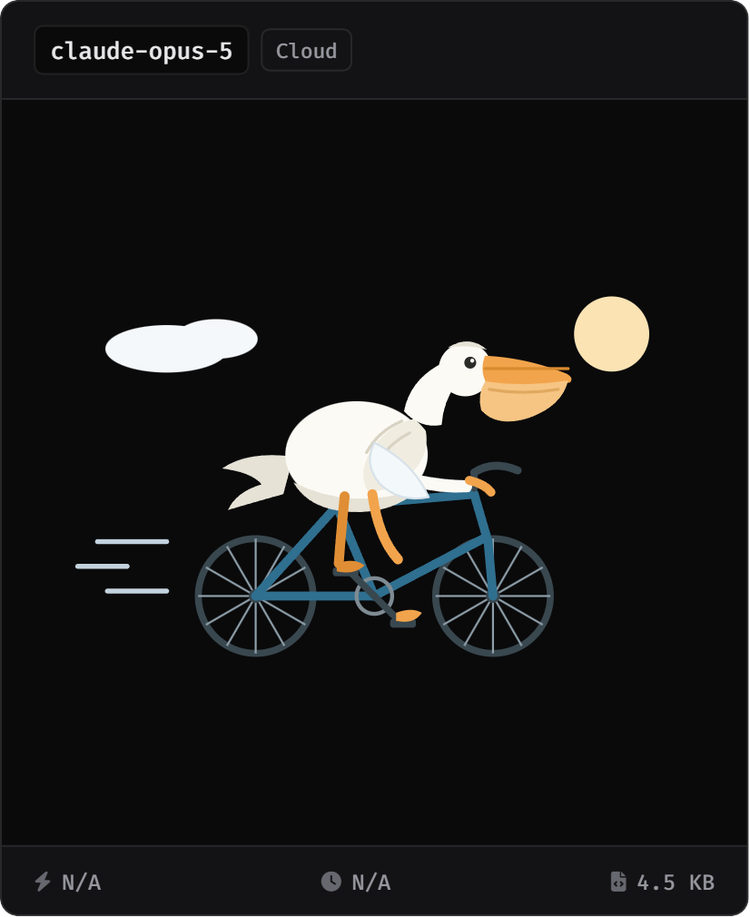
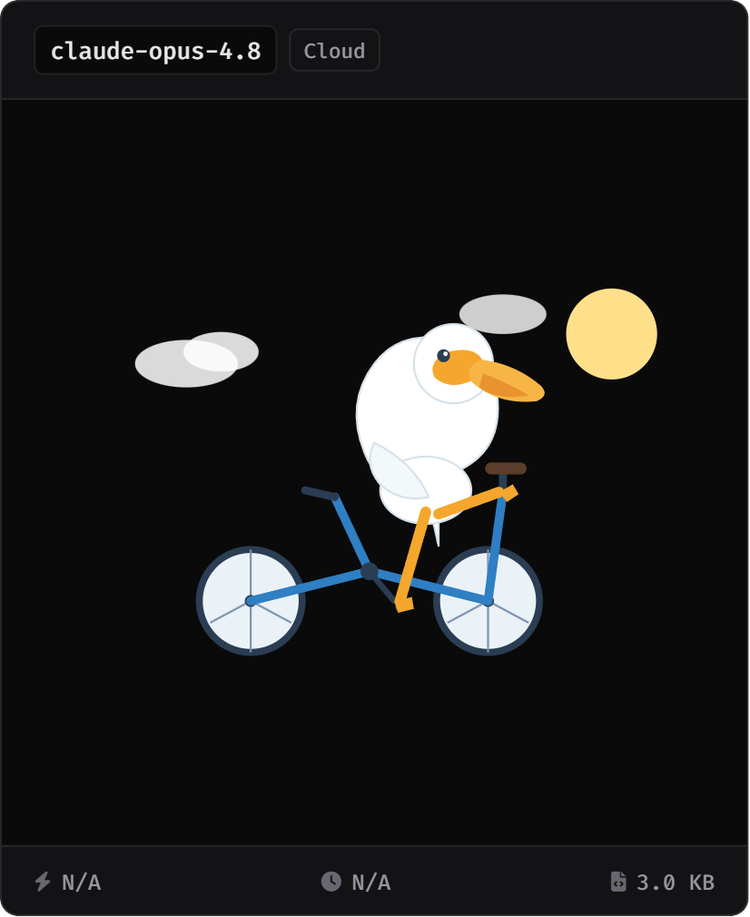
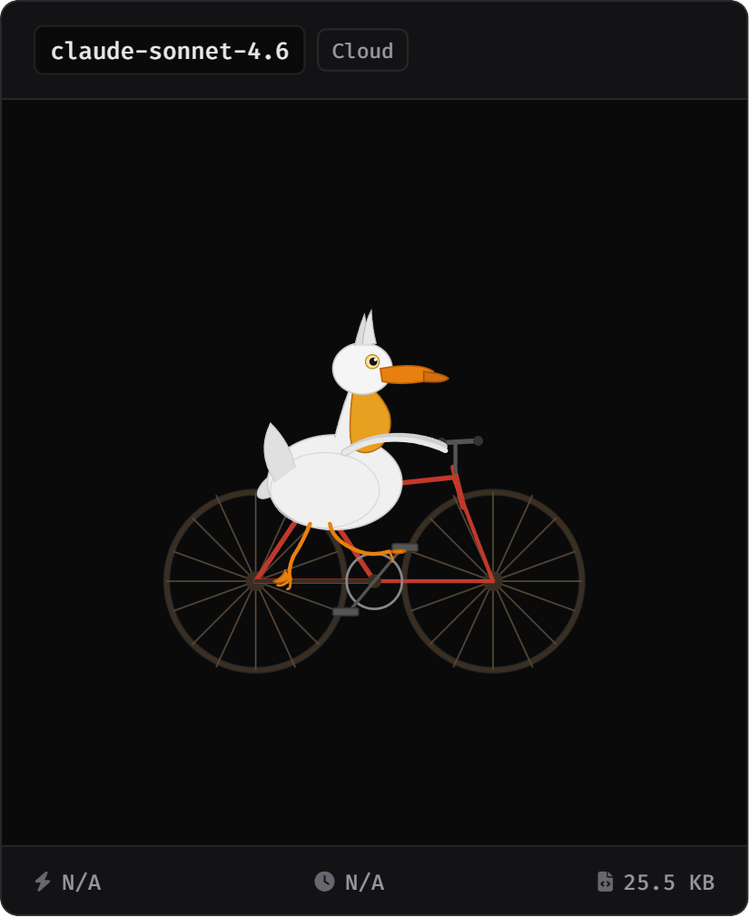
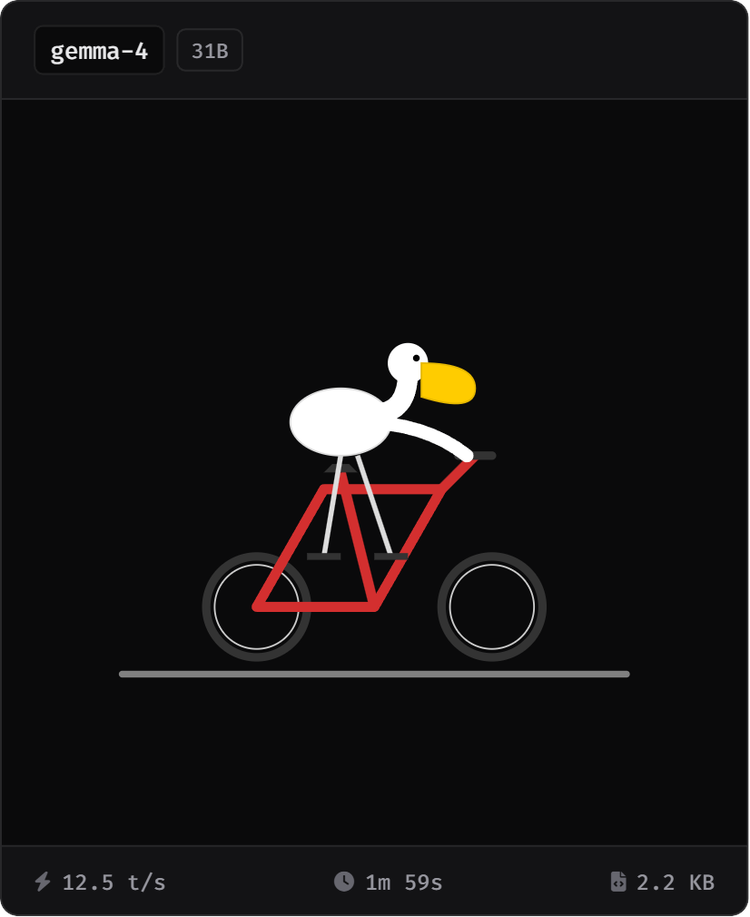
Первой проверкой для новой модели стал стандартный тест с отрисовкой пеликана в формате SVG. Несмотря на то что Qwen 3.8 является плотной моделью с активными 27 миллиардами параметров, она справилась с задачей быстрее, чем ожидалось. На видеокарте RTX 3090 скорость генерации составила 75 токенов в секунду.
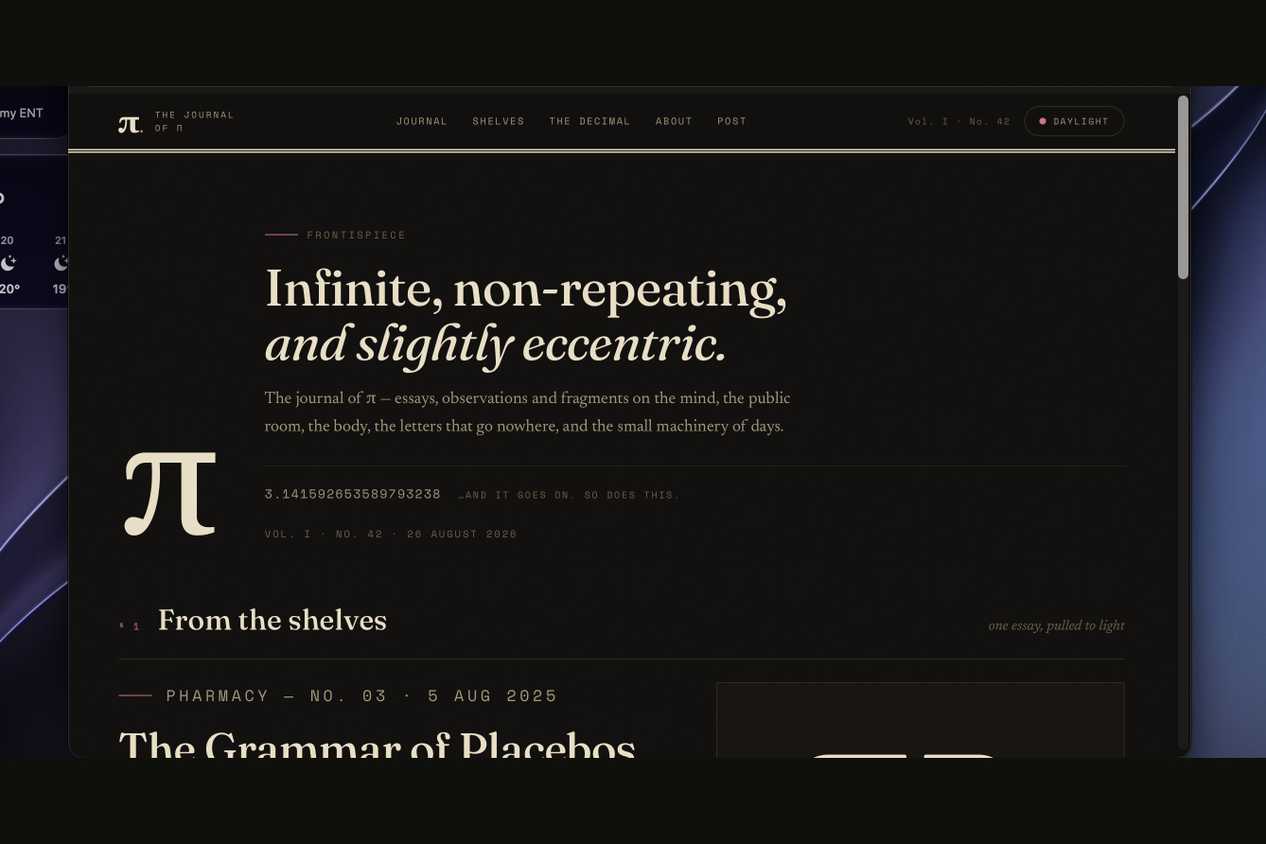
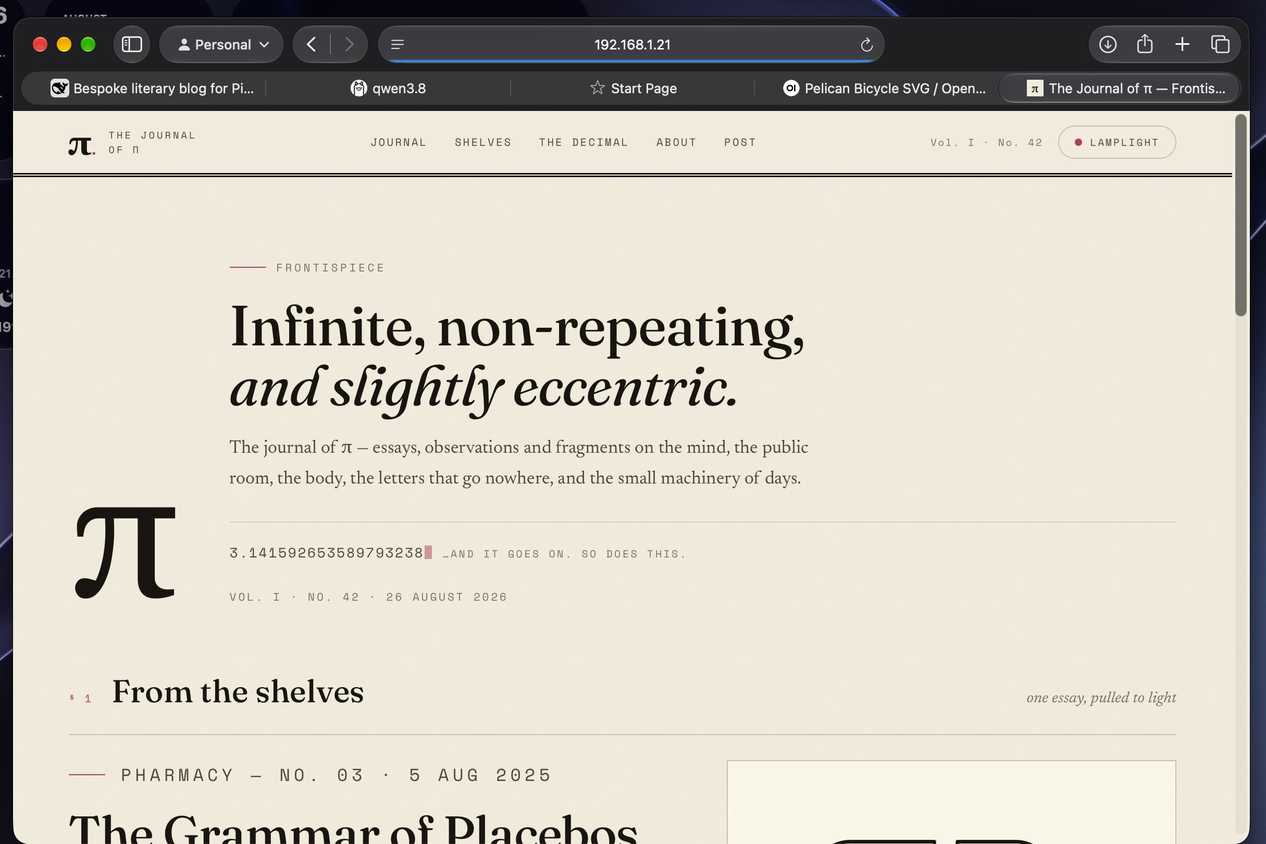
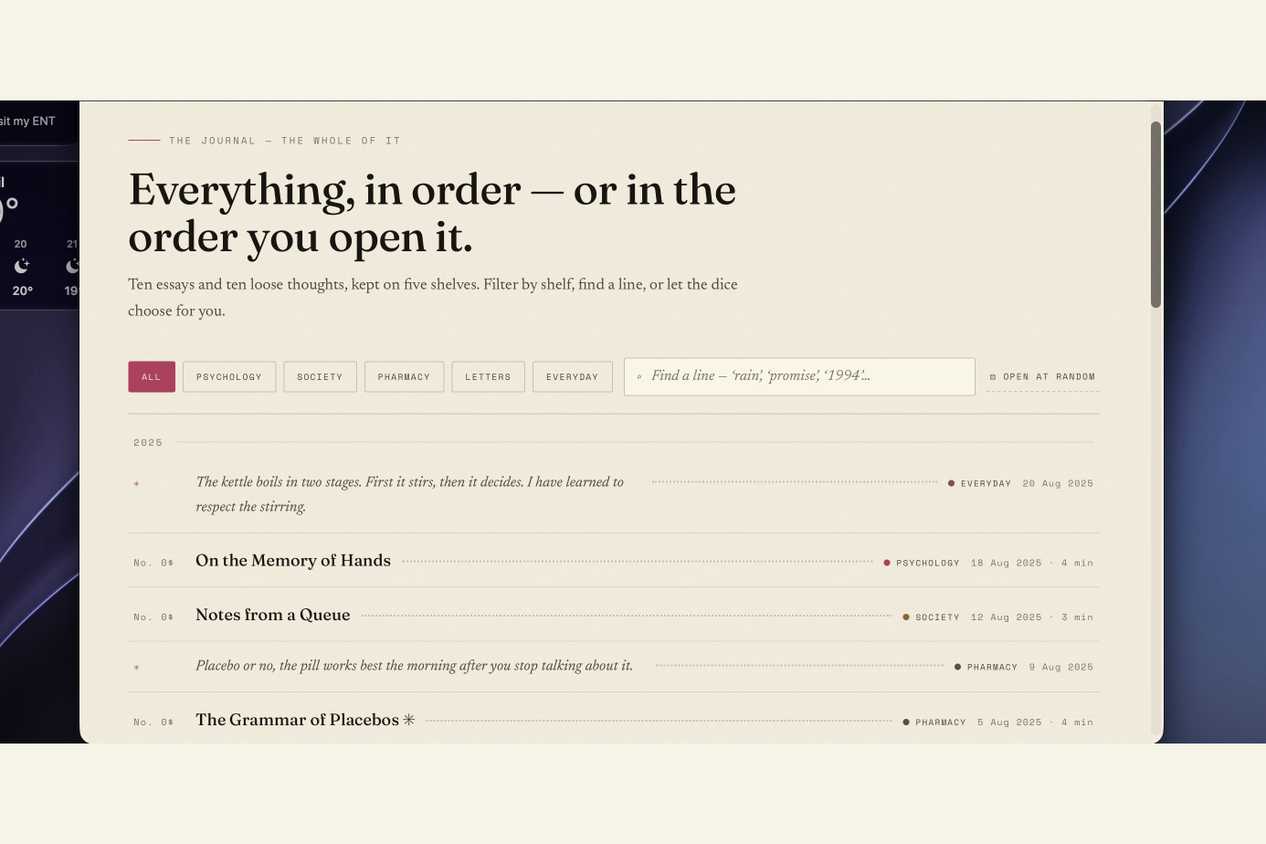
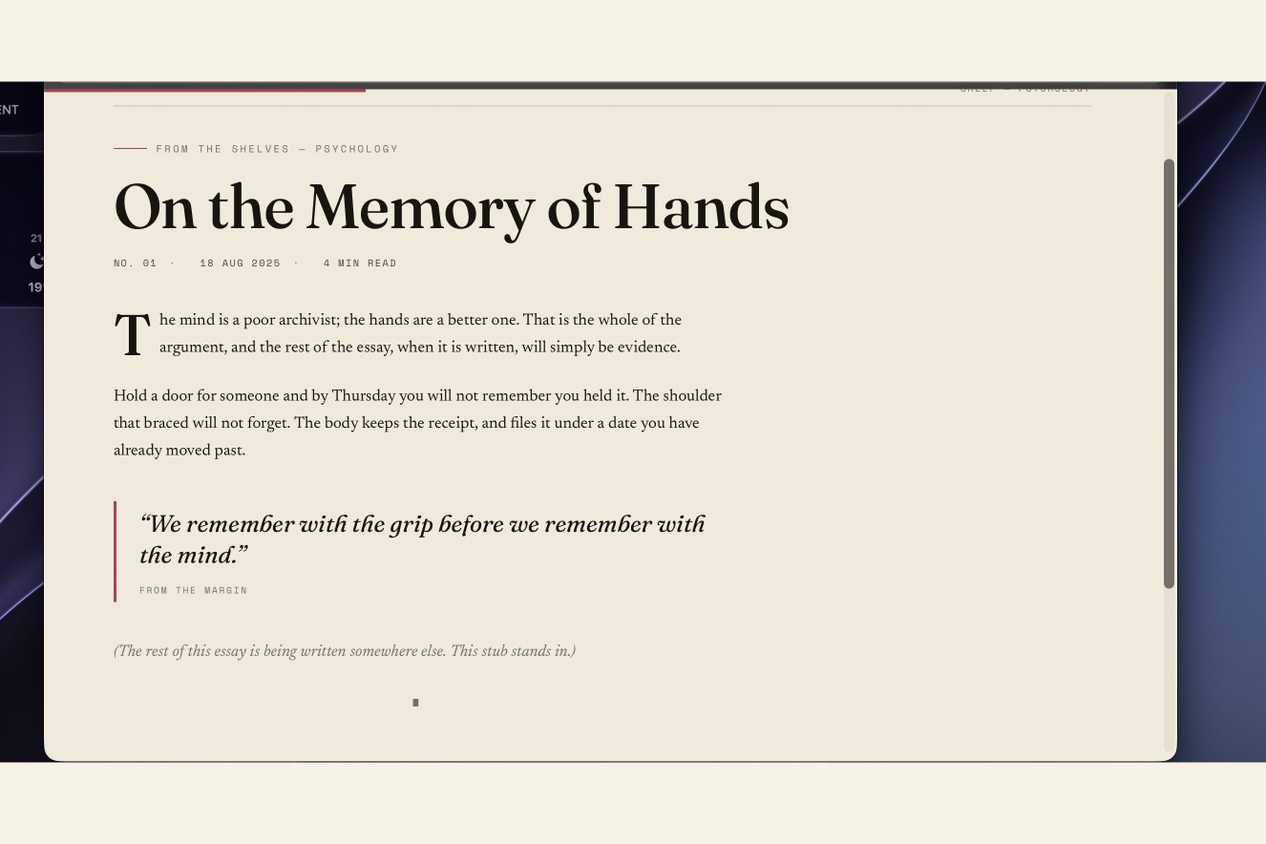
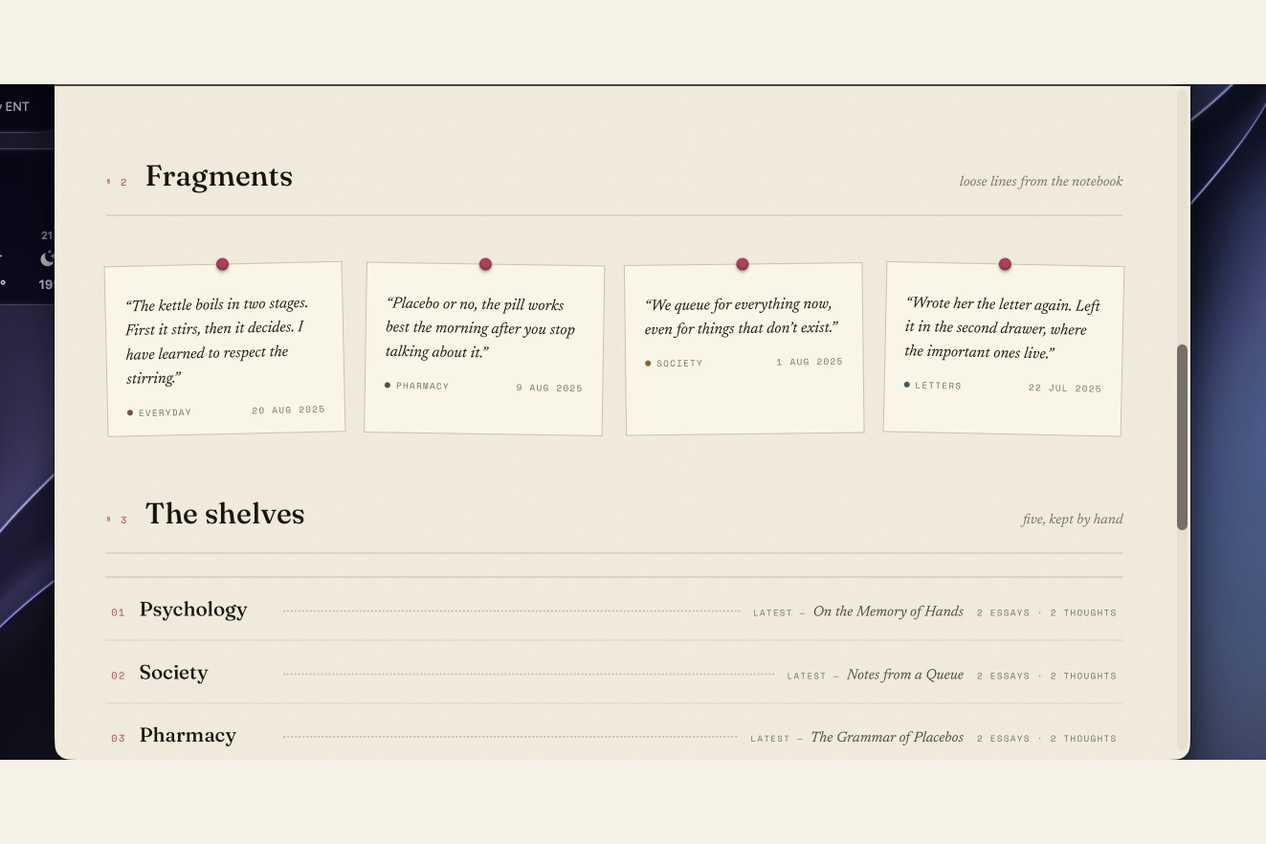
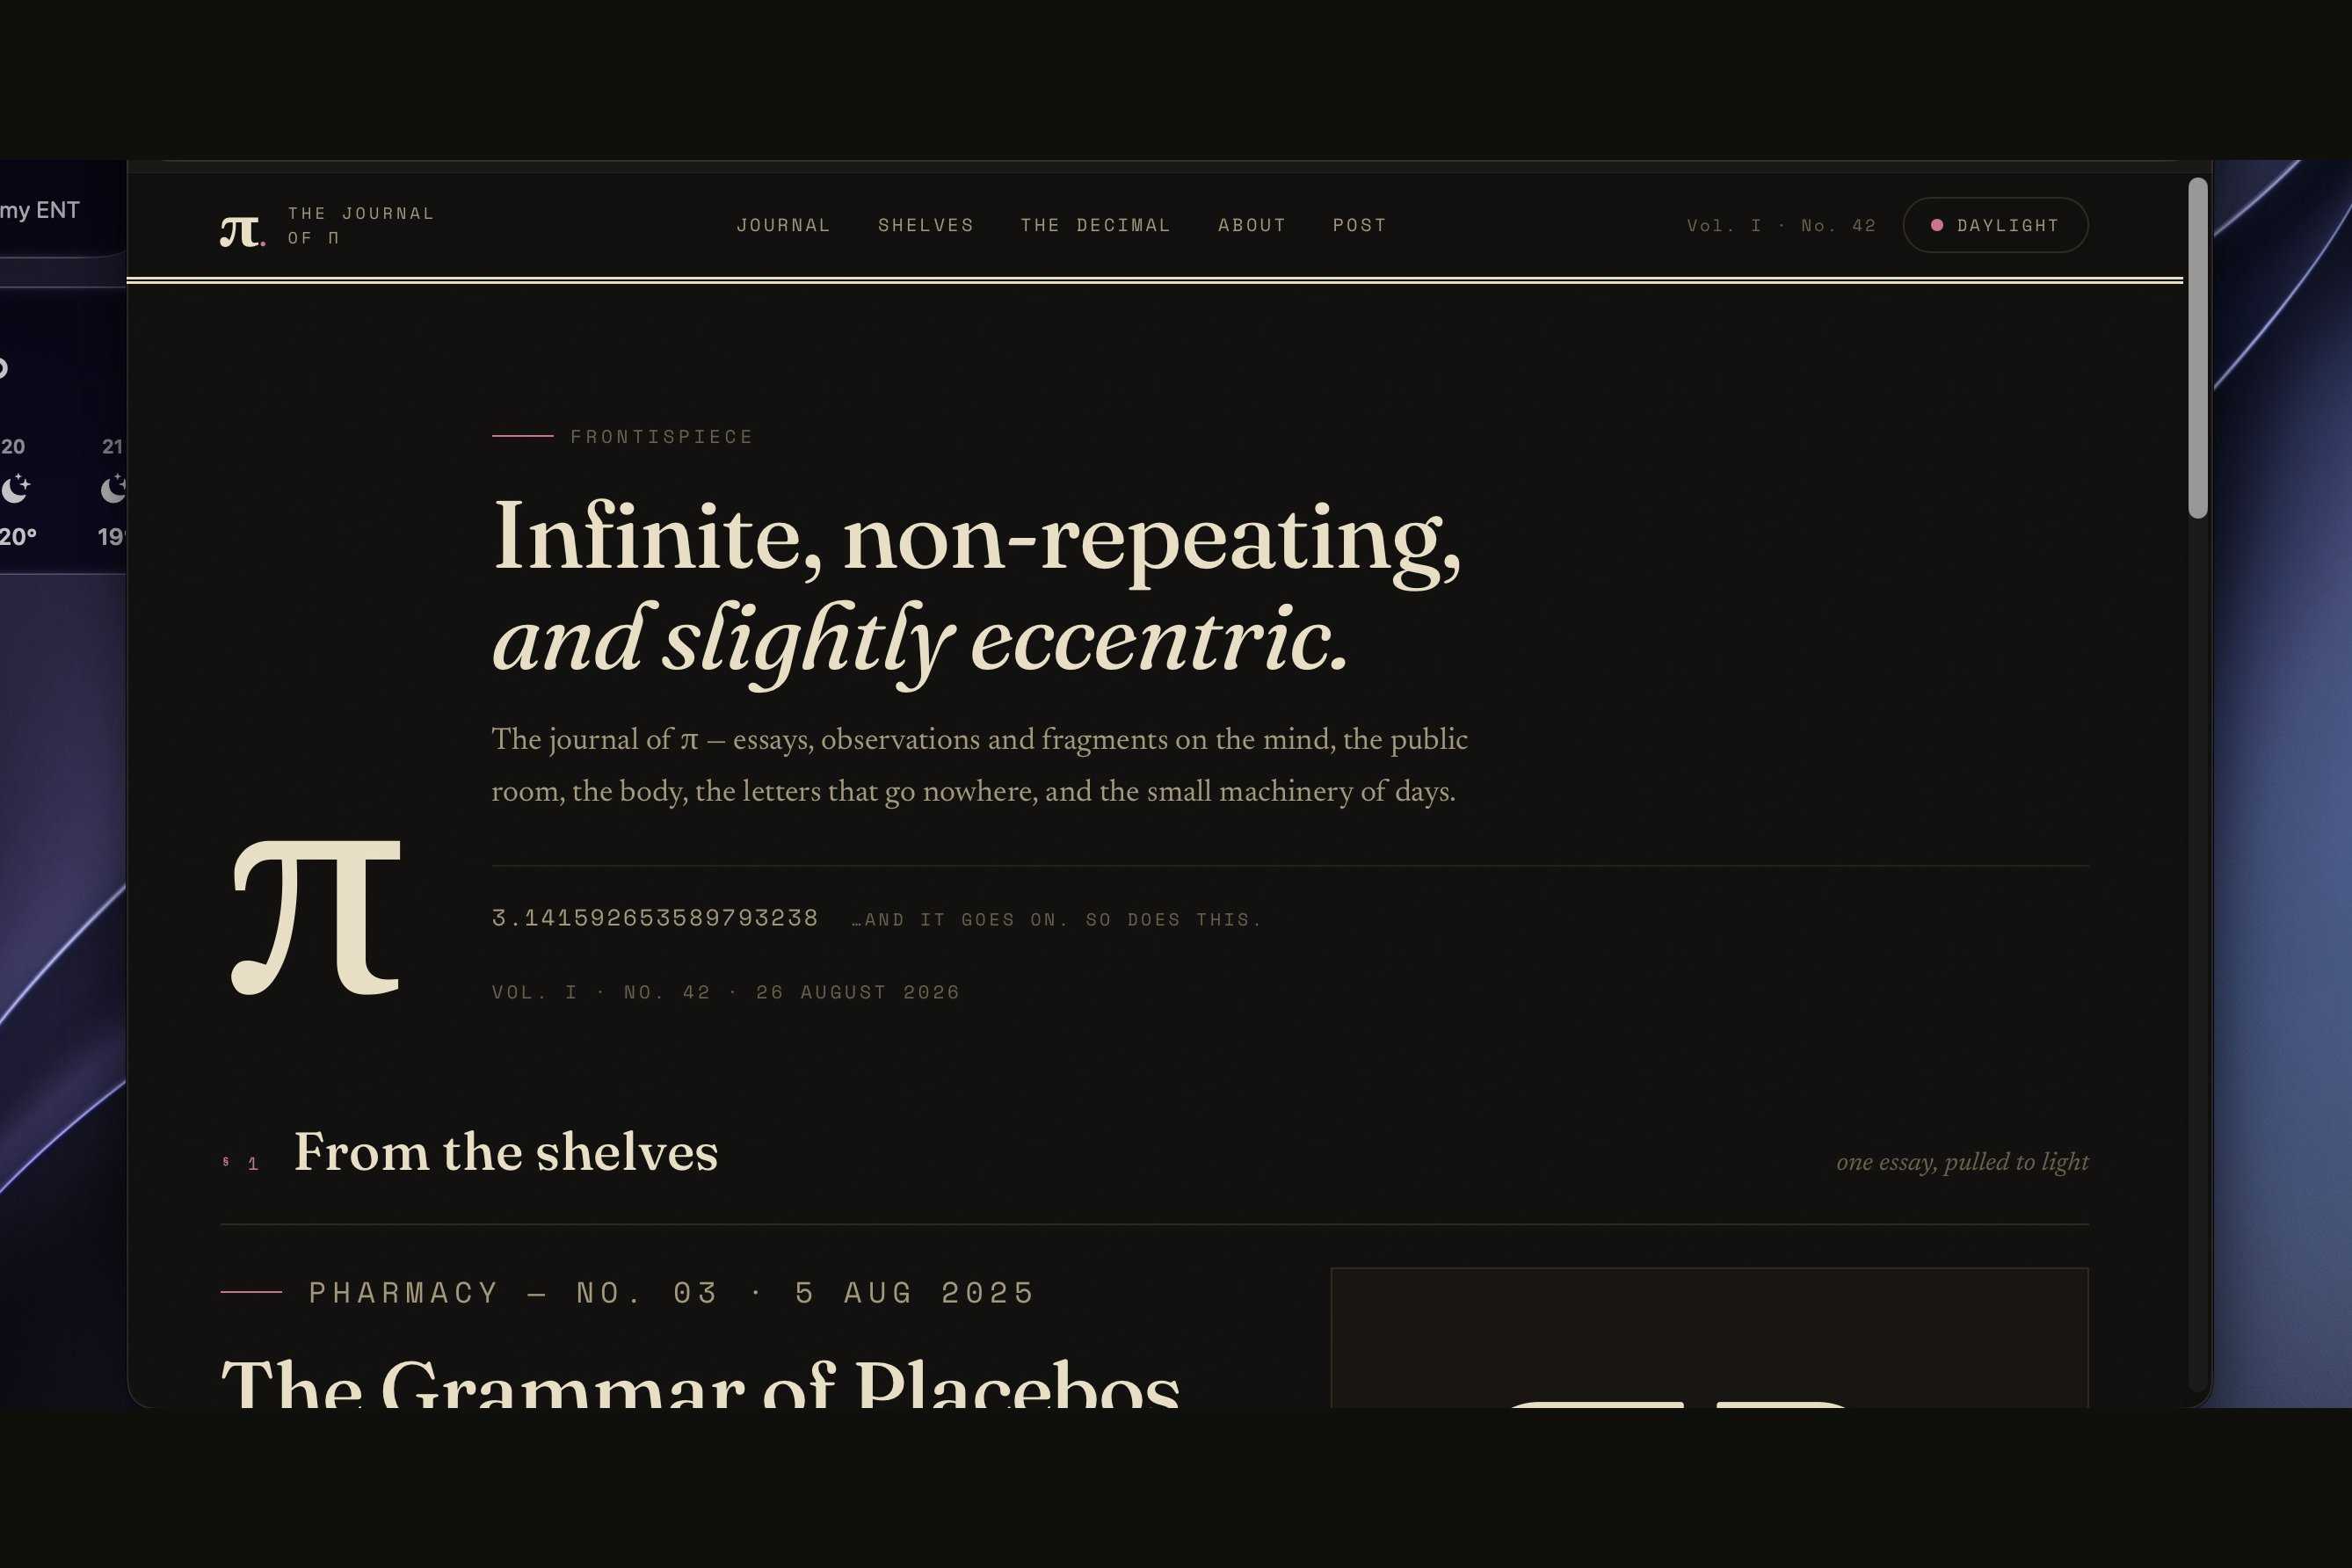
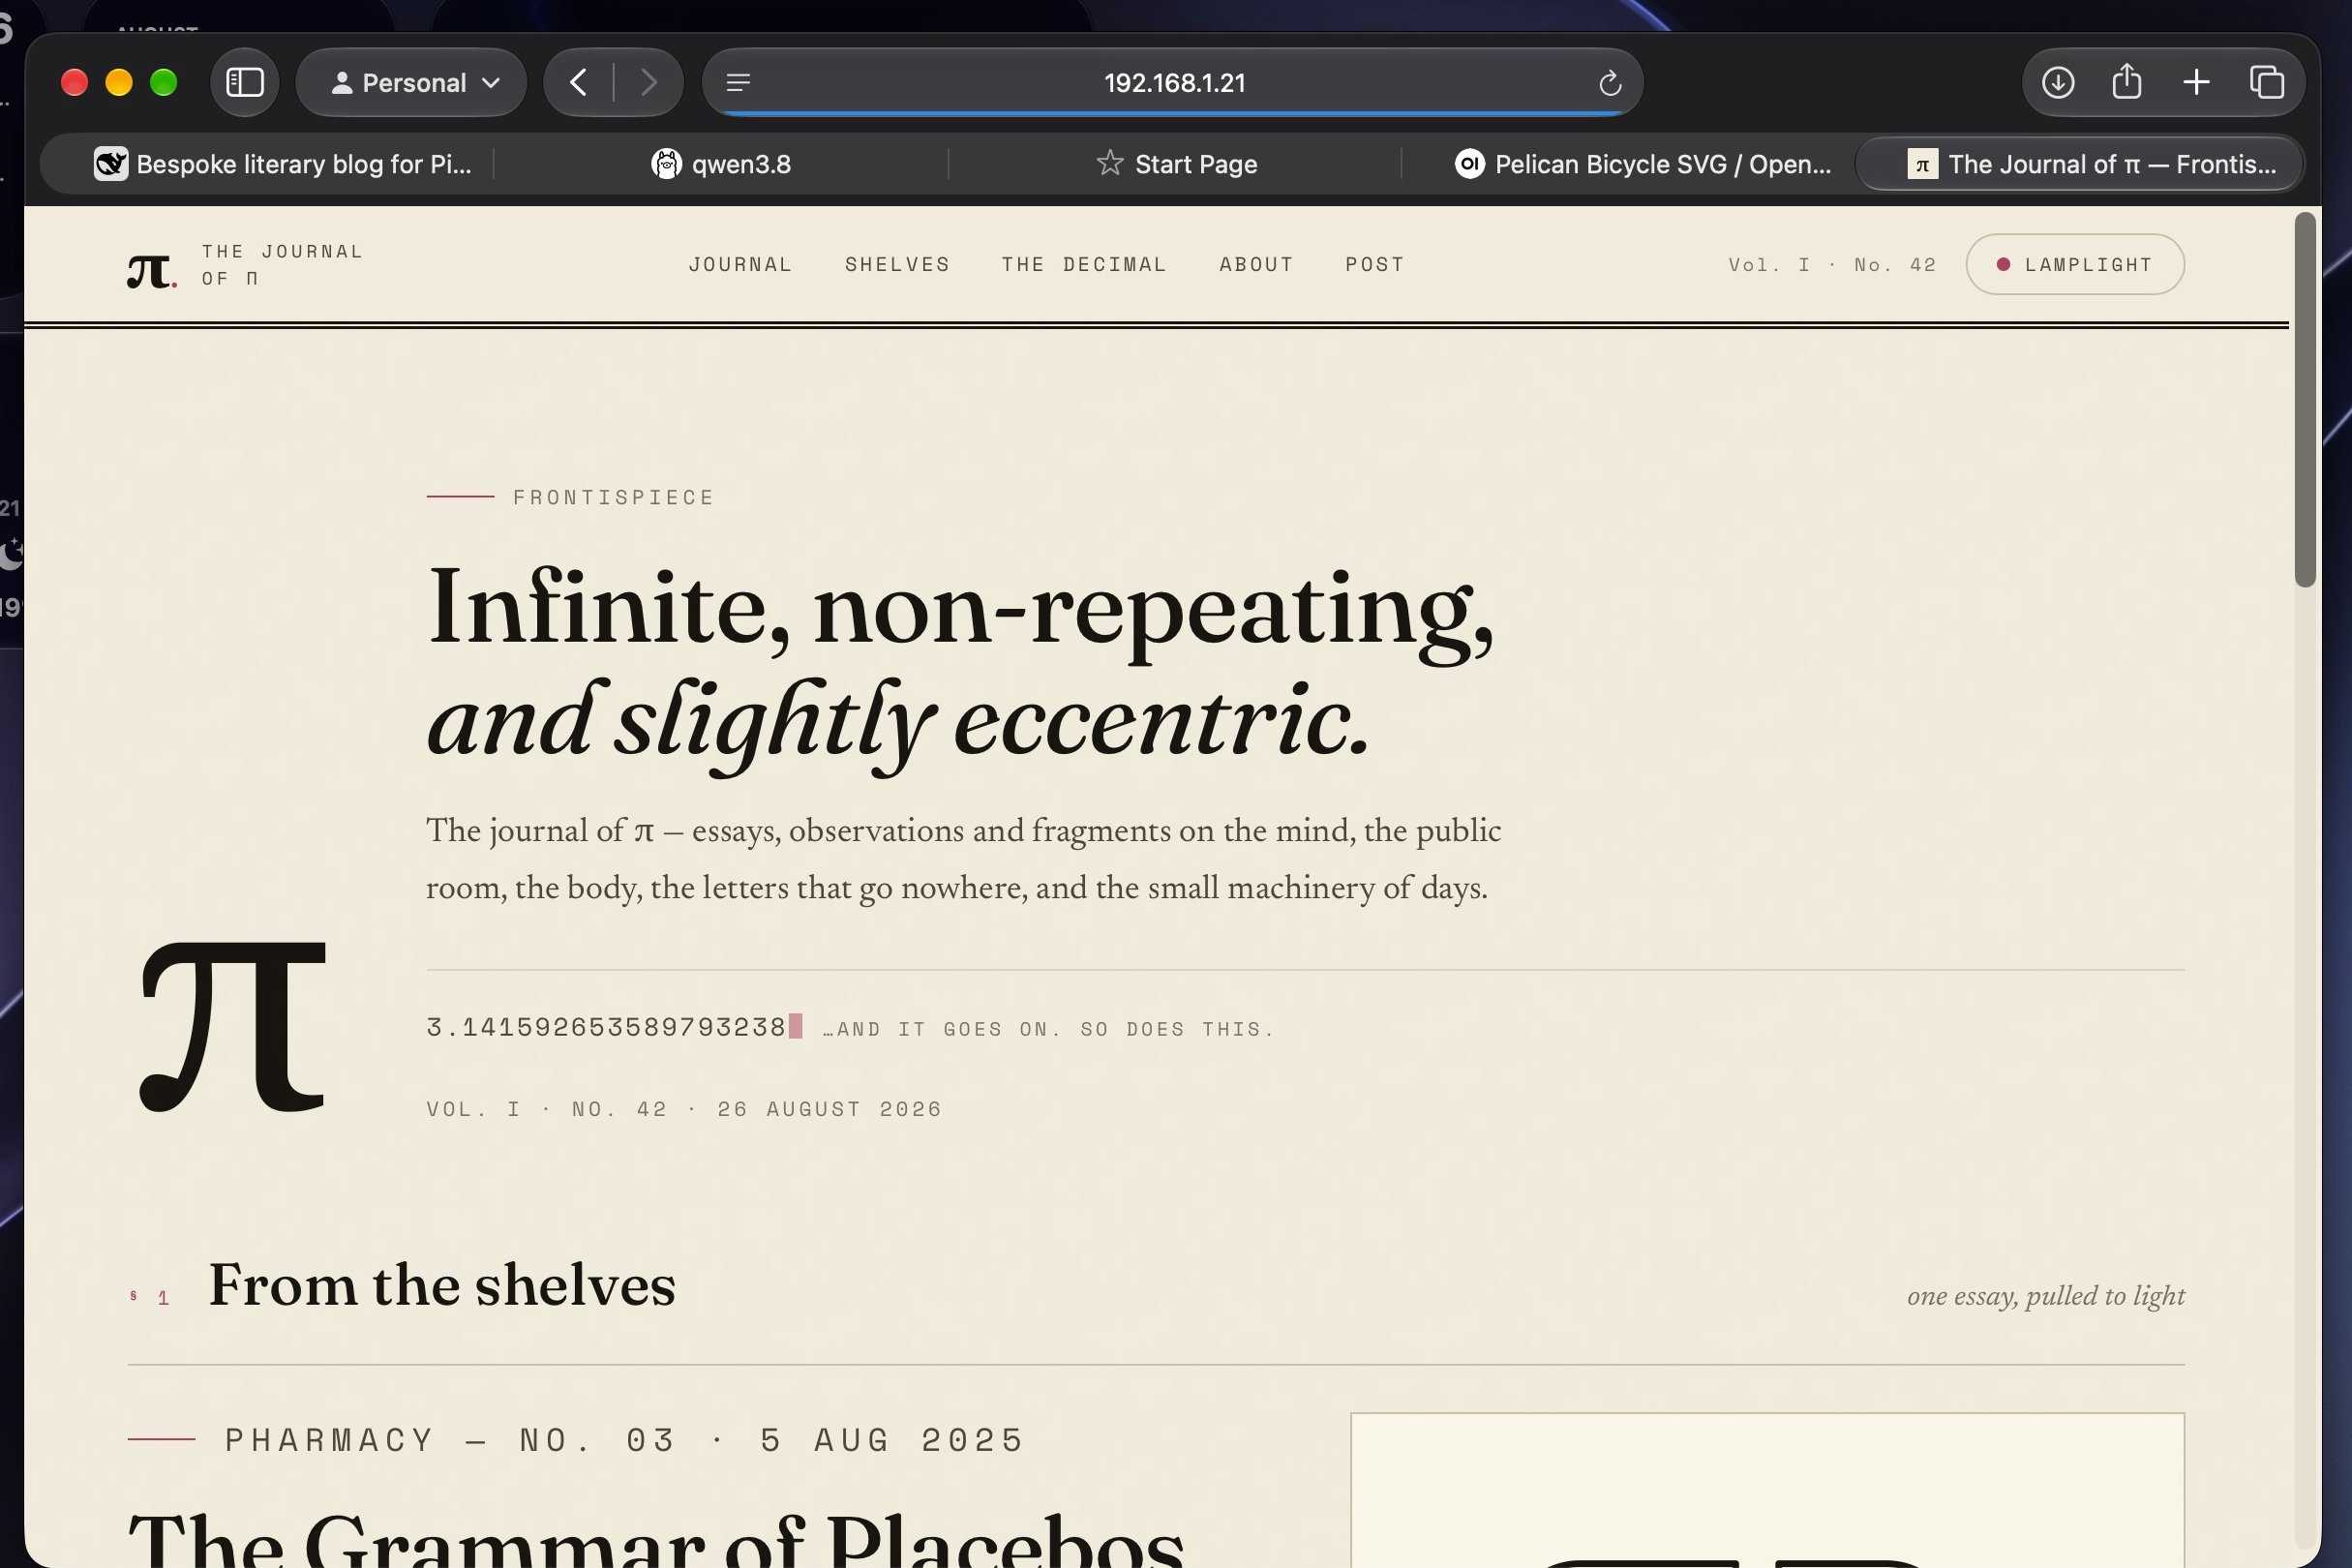
Следующим испытанием стала задача по созданию полноценного блога. Модель справилась с проектированием сайта отлично: структура страниц, макет и дизайн получились продуманными и функциональными, хотя в оформлении прослеживаются стилистические решения, напоминающие разработки Anthropic.
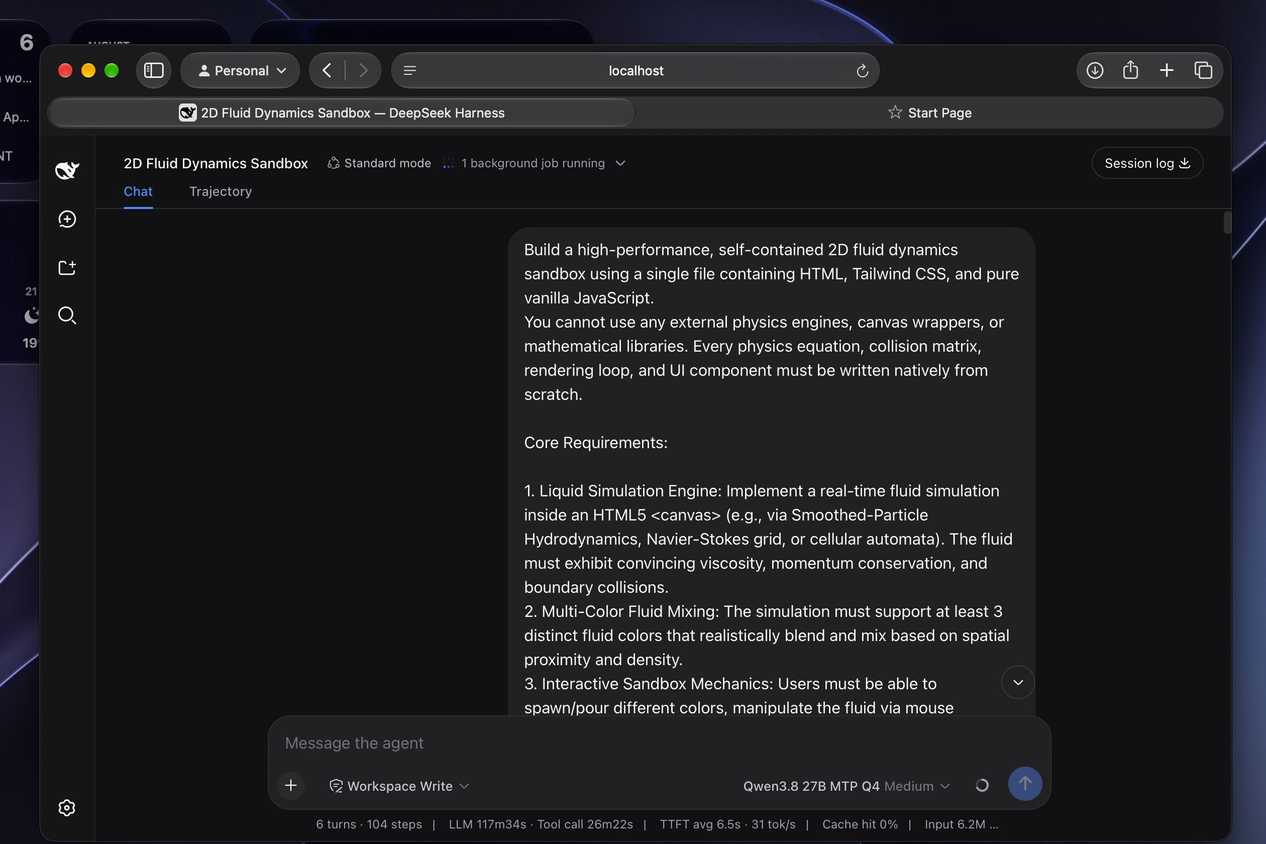
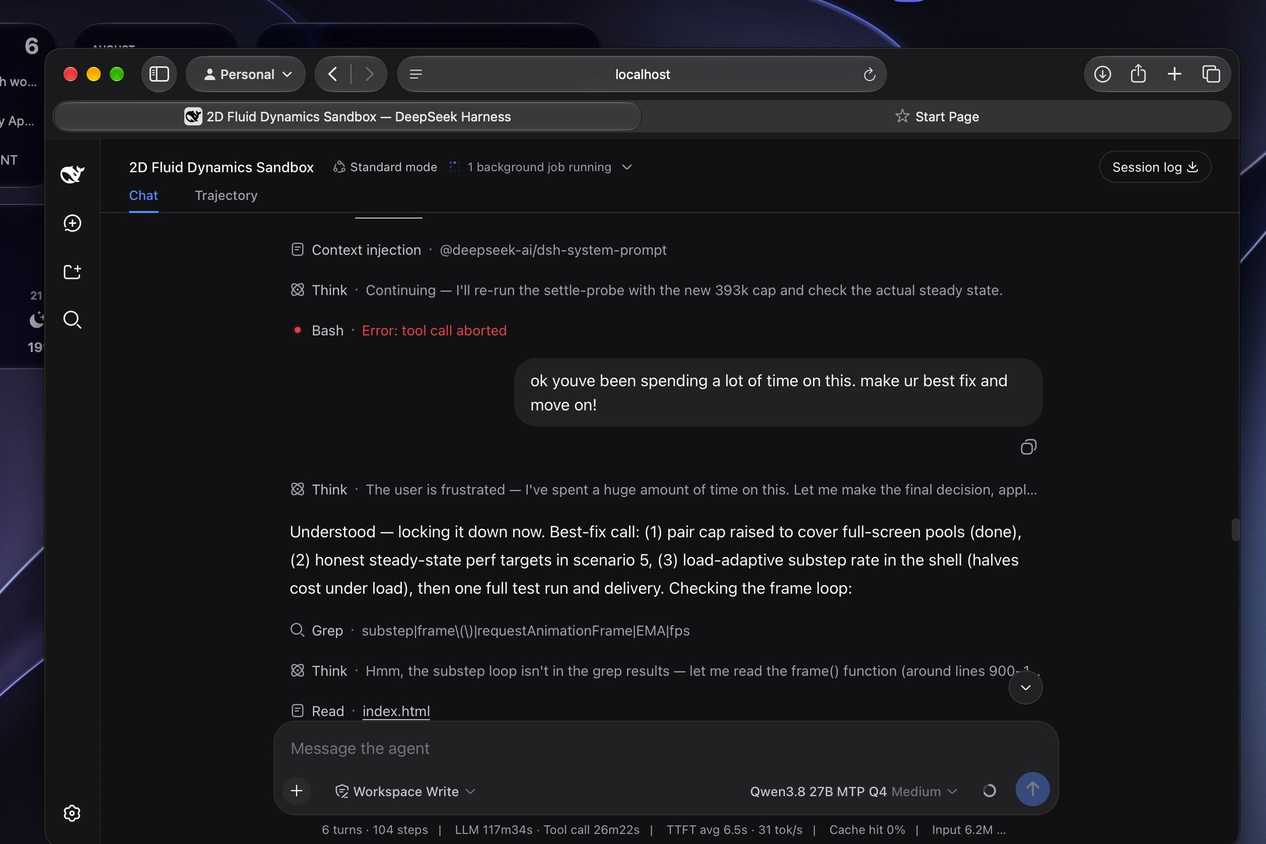
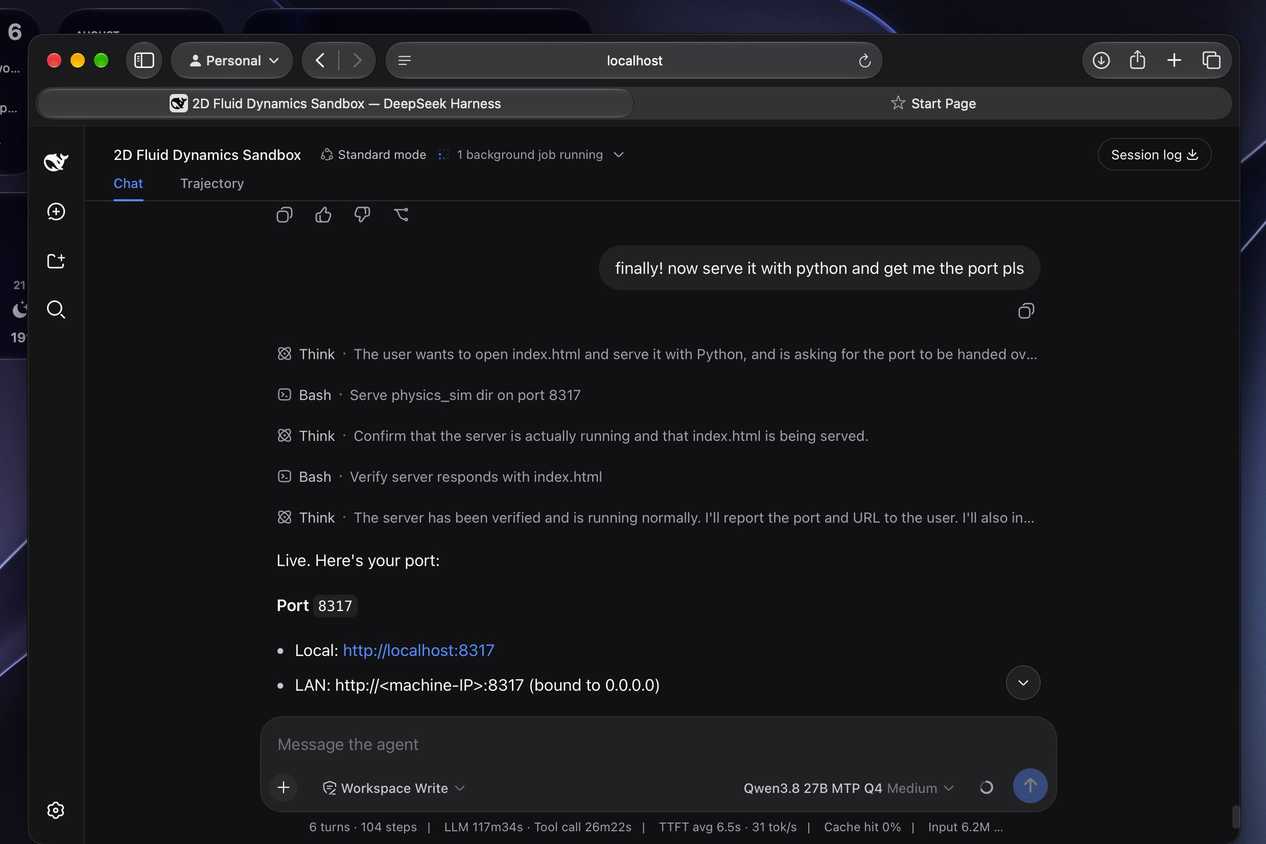
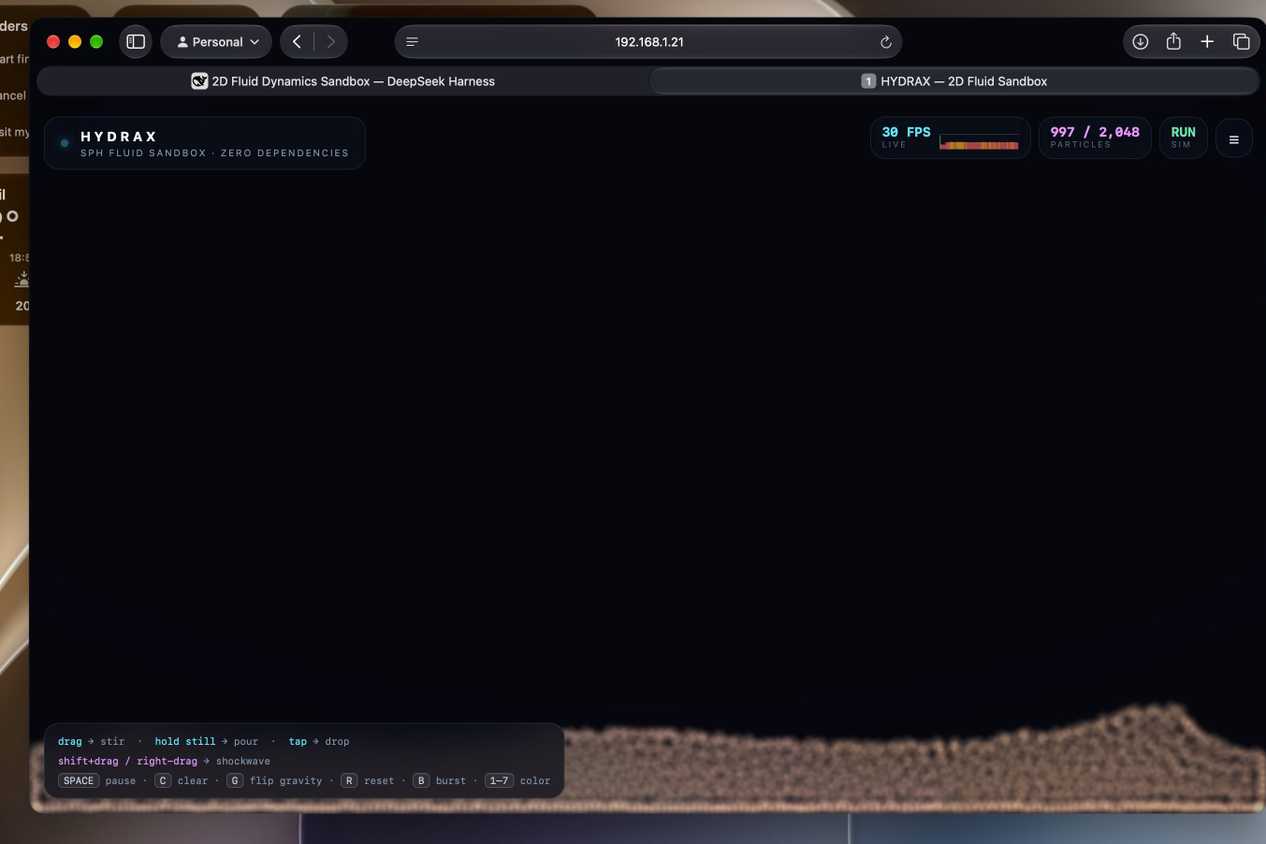
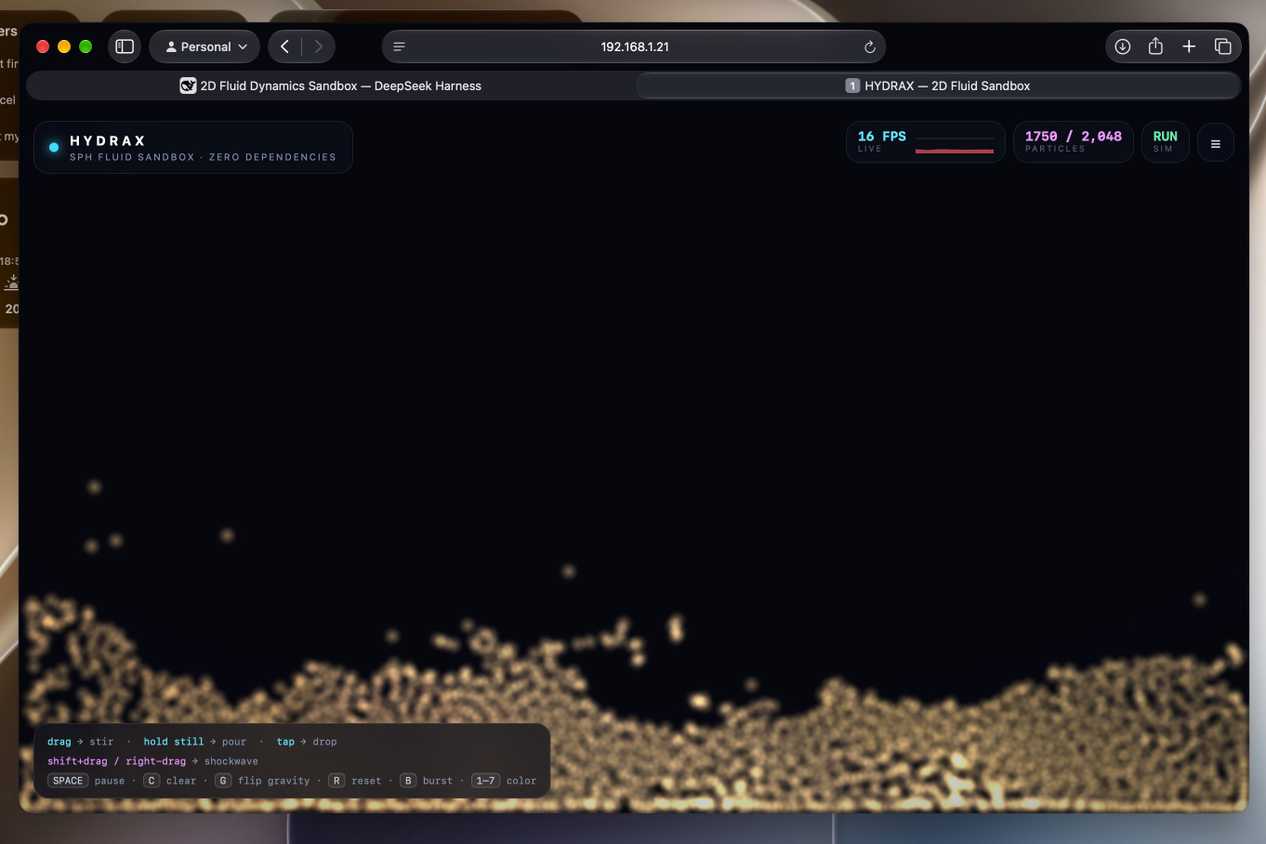
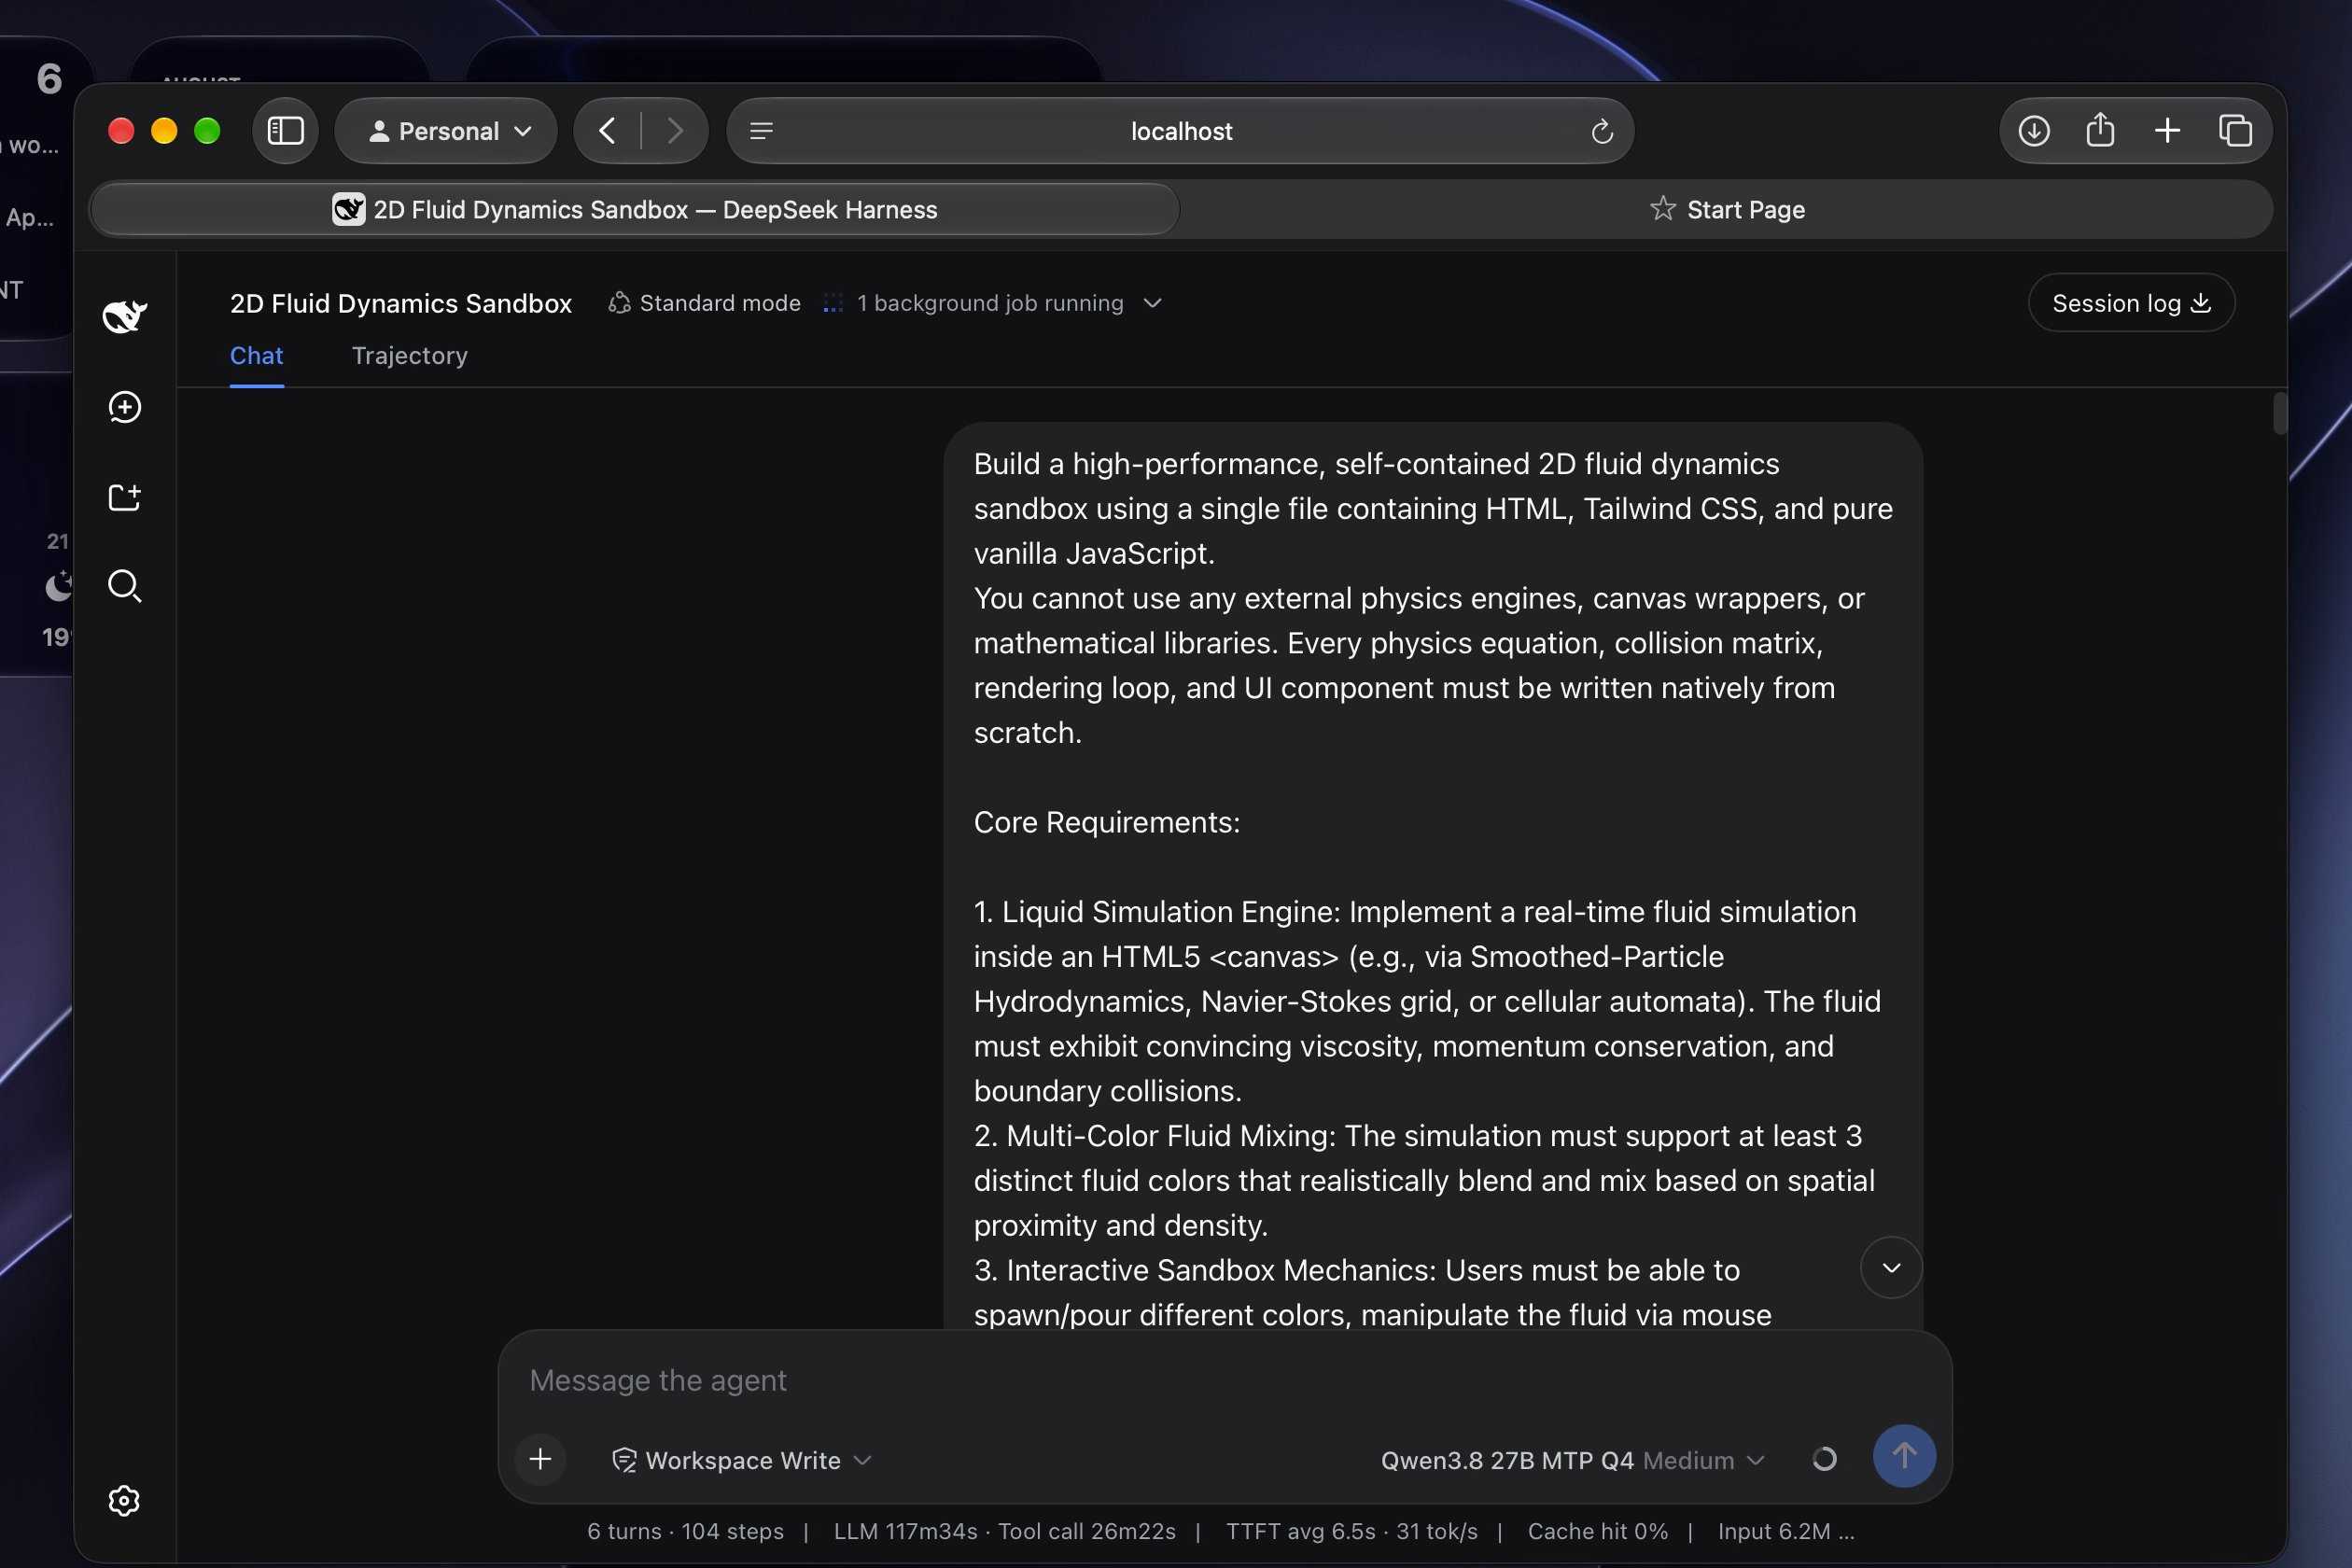
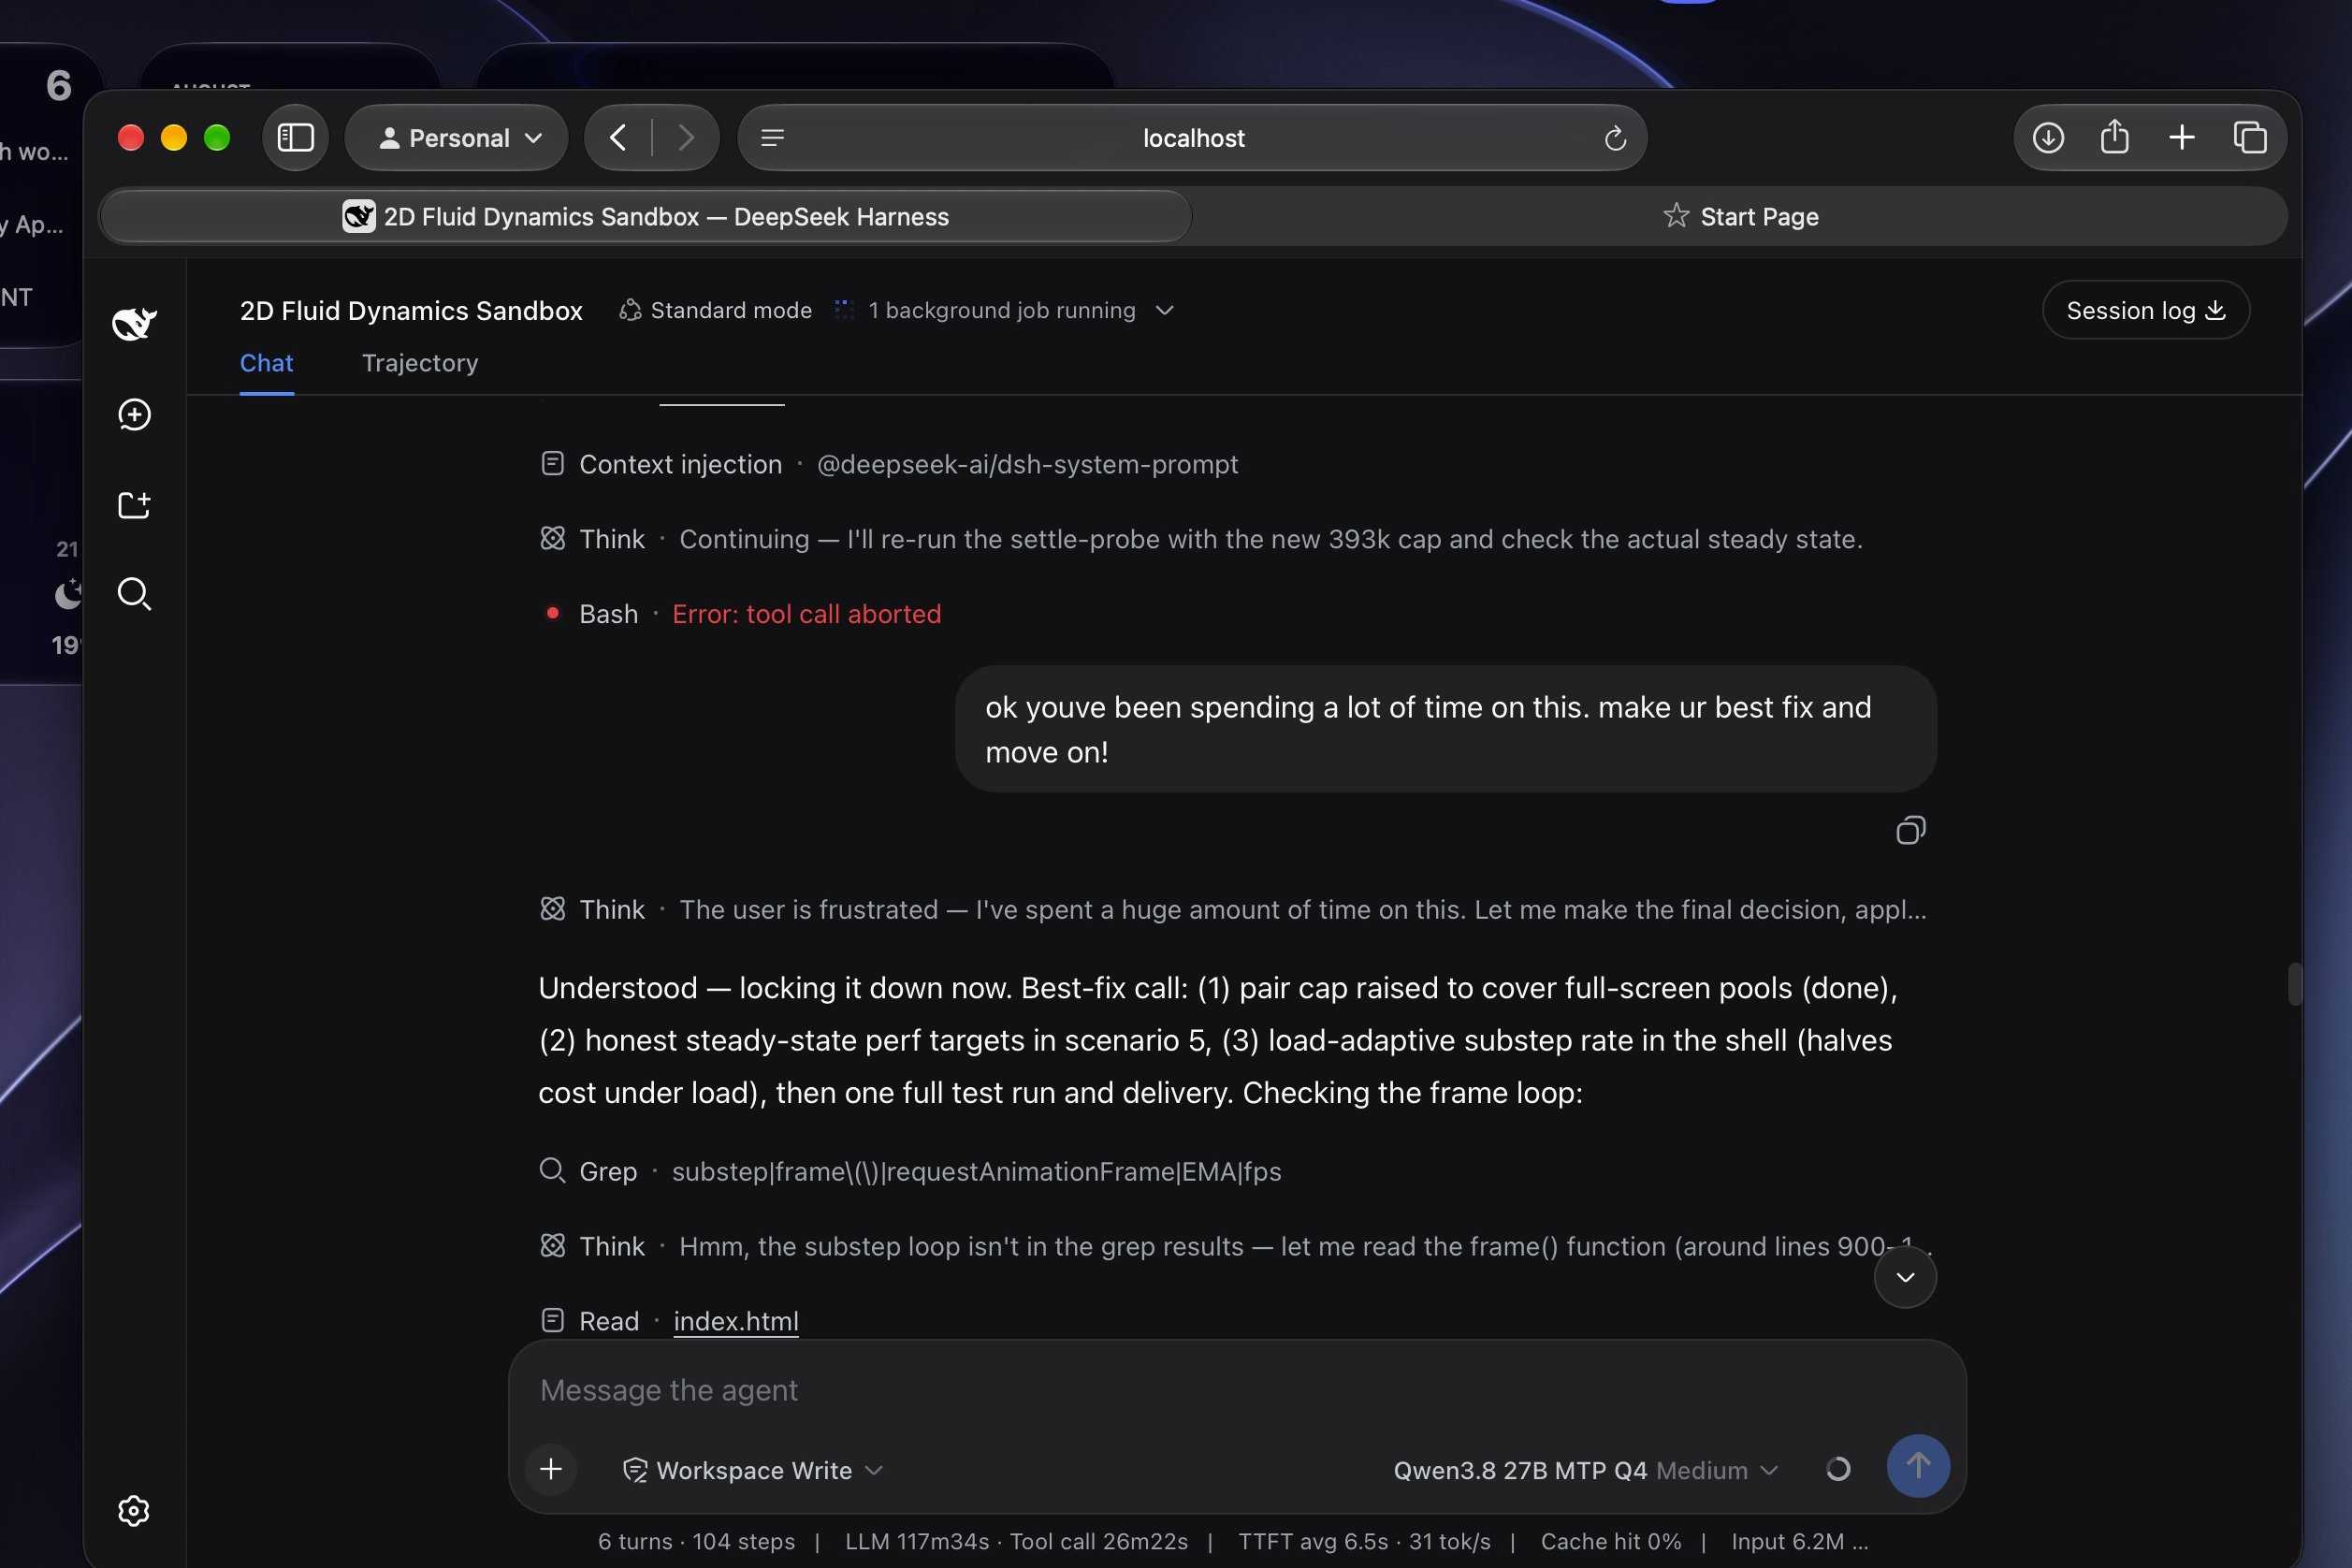
Самым сложным тестом стала разработка симулятора физики жидкостей с нуля без использования готовых библиотек. Для запуска процесса использовался обходной путь через DeepSeek Harness. Модель справилась с задачей примерно за три часа с учетом вмешательства пользователя для сокращения времени тестирования. Единственным существенным недостатком стала производительность: при количестве частиц более 1000 симулятор начинает терять кадры, а при превышении 3 000 частиц становится непригодным для использования, хотя большинство других агентов искусственного интеллекта ограничивают симуляции на отметке в 2000 частиц.
Сравнение локального запуска с облачными гигантами
Важно учитывать масштаб сравнения. Версия с 27 миллиардами параметров является самой компактной в семействе Qwen 3.8. Полноразмерная модель Qwen3.8-2.4T-A95B обладает 2.4 триллиона параметров. Для запуска протестированной квантованной версии Q4_K_M потребовалось 17.8 ГБ видеопамяти только для модели, а с контекстом в 100 000 токенов на базе KV-кэша Q8 общий объем занятой памяти составил 22 ГБ из доступных 24 ГБ на RTX 3090.
Для запуска флагманской версии Qwen 3.8 с 2.4 триллиона параметров потребовалось бы около 1.5 терабайта видеопамяти. Таким образом, локальная система с 24 ГБ памяти сопоставима по результатам с массивными облачными системами ChatGPT и Claude, масштабы которых измеряются терабайтами.
Главным преимуществом крупных облачных платформ остается размер контекстного окна, достигающий 2 миллионов токенов и более, тогда как локальная конфигурация ограничена 100 000 токенов во избежание сбоев видеокарты. Эту проблему можно частично решить с помощью вспомогательных компактных моделей для сжатия контекста или удаления устаревших вызовов инструментов. Кроме того, раньше облачные сервисы выигрывали за счет фирменных программных оболочек вроде Claude Code или Codex, однако развитие открытых аналогов вроде Qwen Code и DeepSeek Harness стирает это различие.
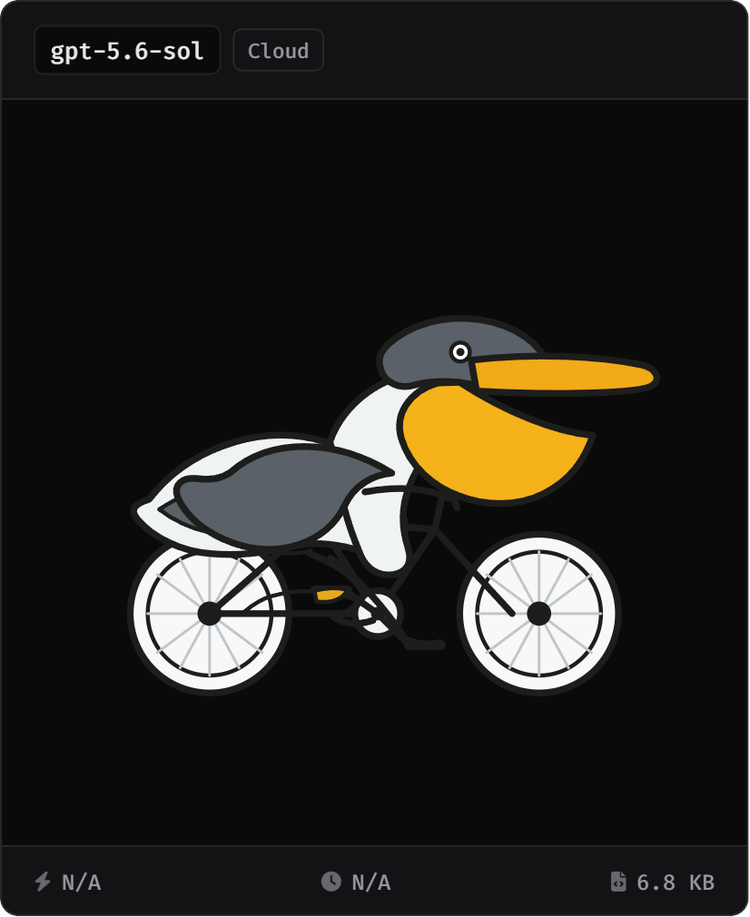
Интересной предысторией релиза стало то, что после выхода моделей Kimi от Moonshot AI компания Anthropic запаниковала и предоставила всем пользователям бесплатные кредиты Fable на сумму 100 долларов. В тестах на рисование SVG-пеликана Qwen 3.8 неожиданно обошла даже модель Opus 5, хотя автор статьи отмечает, что результат может быть специфичным для конкретного промпта и оптимизации.
Для запуска квантованной версии Q4_K_M использовалась формула расчета требований к VRAM, которая включает умножение параметров на биты на вес с делением на 8, добавление KV-кэша и дополнительных возможностей вроде мини-моделей или систем компьютерного зрения. В процессе тестирования симулятора физики жидкостей автор принудительно останавливал работу агента, советуя ему перейти к лучшему решению вместо продолжения бесконечных тестов производительности.
В качестве ключевого вывода автор подчеркивает иронию ситуации: такие гиганты, как OpenAI, Anthropic, Meta и Google, постоянно читают лекции о том, что искусственный интеллект не должен быть монополией и каждый должен иметь доступ к качественным моделям, хотя компания Alibaba не делала подобных громких заявлений, но фактически предоставила именно такое решение.
Дополнительные технические подробности и результаты тестов Qwen 3.8
Новое поколение открытых моделей получило название «Mythos-class». Это огромные и крайне эффективные системы, которые в реальном использовании становится все труднее отличить от передовых облачных решений. Помимо Qwen 3.8 от Alibaba, на рынке появились модели Kimi от Moonshot AI с настолько фантастическими результатами бенчмарков, что компания Anthropic была вынуждена выдать всем пользователям бесплатные кредиты Fable на сумму 100 долларов, а следом компания DeepSeek представила модель V4 Pro.
Что касается архитектуры, Qwen 3.8 27B является плотной (dense) моделью. Это означает, что все 27 миллиардов параметров задействованы одновременно. Несмотря на это и на сложность создаваемых объектов, модель демонстрирует высокую скорость работы: даже на потребительской видеокарте RTX 3090 генерация в тесте с SVG-пеликаном достигала 75 токенов в секунду.
В ходе сравнительного тестирования автор материала сопоставил результаты локальной модели с показателями Claude и GPT, а в тесте с рисованием пеликана Qwen 3.8 даже превзошла модель Opus 5, хотя автор делает оговорку, что разработчики из Alibaba могли специально обучить модель лучше справляться с подобными графическими задачами.
Особенности тестирования кодинга и физического симулятора
Для проверки сложных навыков программирования использовался агентский подход. Задача заключалась в написании симулятора физики жидкостей с нуля, без подключения готовых библиотек и наложения на них пользовательского интерфейса. В качестве рабочей среды для Qwen 3.8 применялся инструмент DeepSeek Harness. Ранее аналогичные тесты для оценки возможностей систем Fable (Claude Code) и GPT 5.6 Sol (Codex) запускались через собственные программные оболочки.
Выполнение этой амбициозной задачи заняло у модели почти три часа, причем потребовалось вмешательство пользователя: на определенном этапе тестирования производительности автор порекомендовал агенту прекратить бесконечные проверки и перейти к использованию оптимального готового решения.
В сегменте открытых программных оболочек для работы с кодом сегодня наблюдается активный рост альтернативных решений, таких как Qwen Code и DeepSeek Harness, которые успешно заменяют проприетарные среды вроде Claude Code, Cowork, Codex и Work.
Аспекты потребления памяти и инфраструктурные ограничения
Точный расчет требований к видеопамяти (VRAM) для запуска локальных моделей определяется по формуле:
- умножение количества параметров на количество бит на вес с последующим делением на 8;
- добавление объема KV-кэша;
- учет дополнительных возможностей или встроенных мини-моделей (например, модулей компьютерного зрения).
Для запуска полноразмерной флагманской версии Qwen3.8-2.4T-A95B с 2.4 триллиона параметров даже с использованием квантования Q4_K_M потребовалось бы около 1.5 терабайта видеопамяти.
Главным техническим препятствием для локального использования остается ограничение контекстного окна. Удержать контекст более чем на 100 000 токенов на потребительской видеокарте проблематично, так как это приводит к сбоям оборудования, в то время как облачные системы флагманского уровня поддерживают окна от 2 миллионов токенов и выше. Для обхода этого ограничения применяются вспомогательные методы: подключение компактной вспомогательной модели для постоянного сжатия контекста и сохранения только ключевой информации, а также автоматическое удаление устаревших вызовов инструментов для освобождения свободного пространства.