Использование локальных языковых моделей (LLM) для ежедневных задач сопряжено с известной проблемой: после завершения конкретного чата модель «забывает» полученные исправления. Даже если пользователь скорректировал неверный ответ, эти знания не сохраняются для будущих сессий. Чтобы решить эту проблему, была разработана утилита Mistake Memory, которая позволяет создать своего рода базу знаний для дообучения модели.
Архитектура и возможности системы Mistake Memory
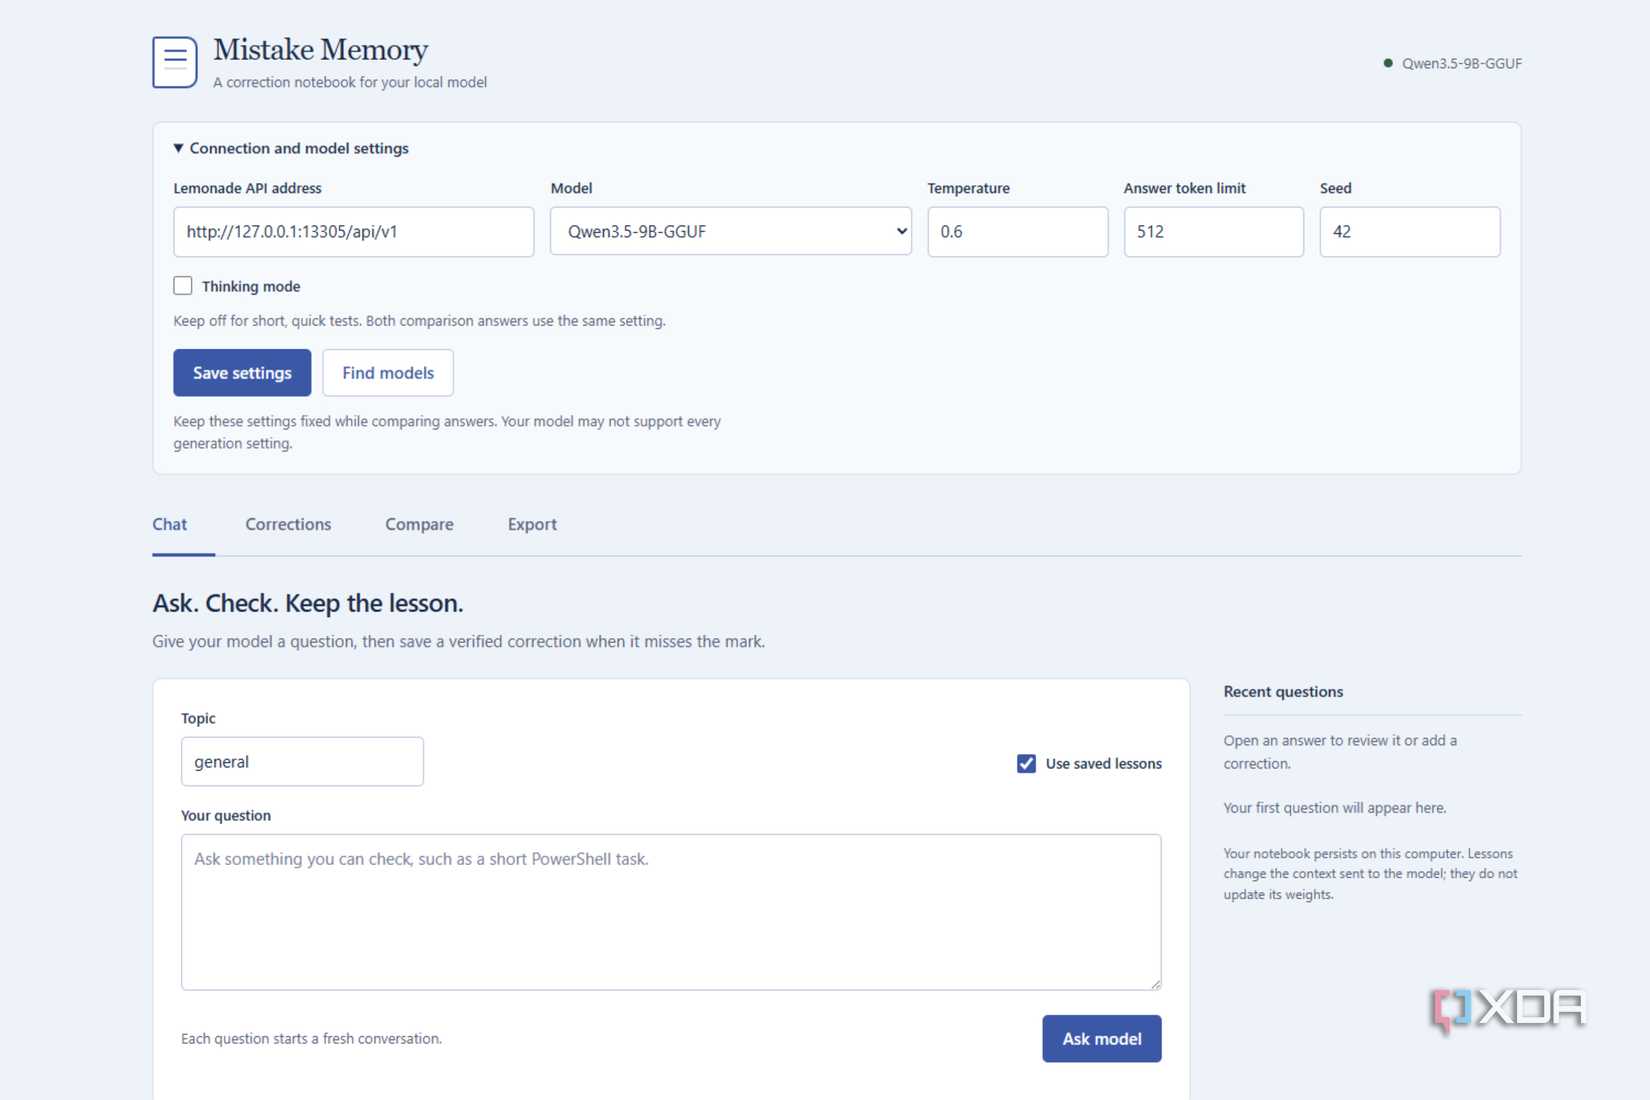
Приложение Mistake Memory представляет собой легковесное решение, в основе которого лежат Python-код для обработки запросов, база данных SQLite для хранения исправлений и контекста, а также веб-интерфейс для взаимодействия. В качестве вычислительной основы используется небольшая модель Qwen, работающая через Lemonade, что обеспечивает совместимость с API в стиле OpenAI без необходимости внедрять громоздкие зависимости.
Пользовательский интерфейс программы разделен на четыре ключевых блока: Chat, Corrections, Compare и Export. Вкладка Chat запускает каждый запрос как отдельный сеанс, исключая влияние истории предыдущих сообщений на результат. Важной особенностью является возможность активации режима использования сохраненных коррекций. В разделе Corrections пользователь может зафиксировать исходный вопрос, ошибочный ответ модели, верный вариант и набор правил, помогающих избежать повторных сбоев. В дальнейшем эти данные используются для автоматической корректировки ответов модели в аналогичных сценариях.
Процесс обучения и верификации
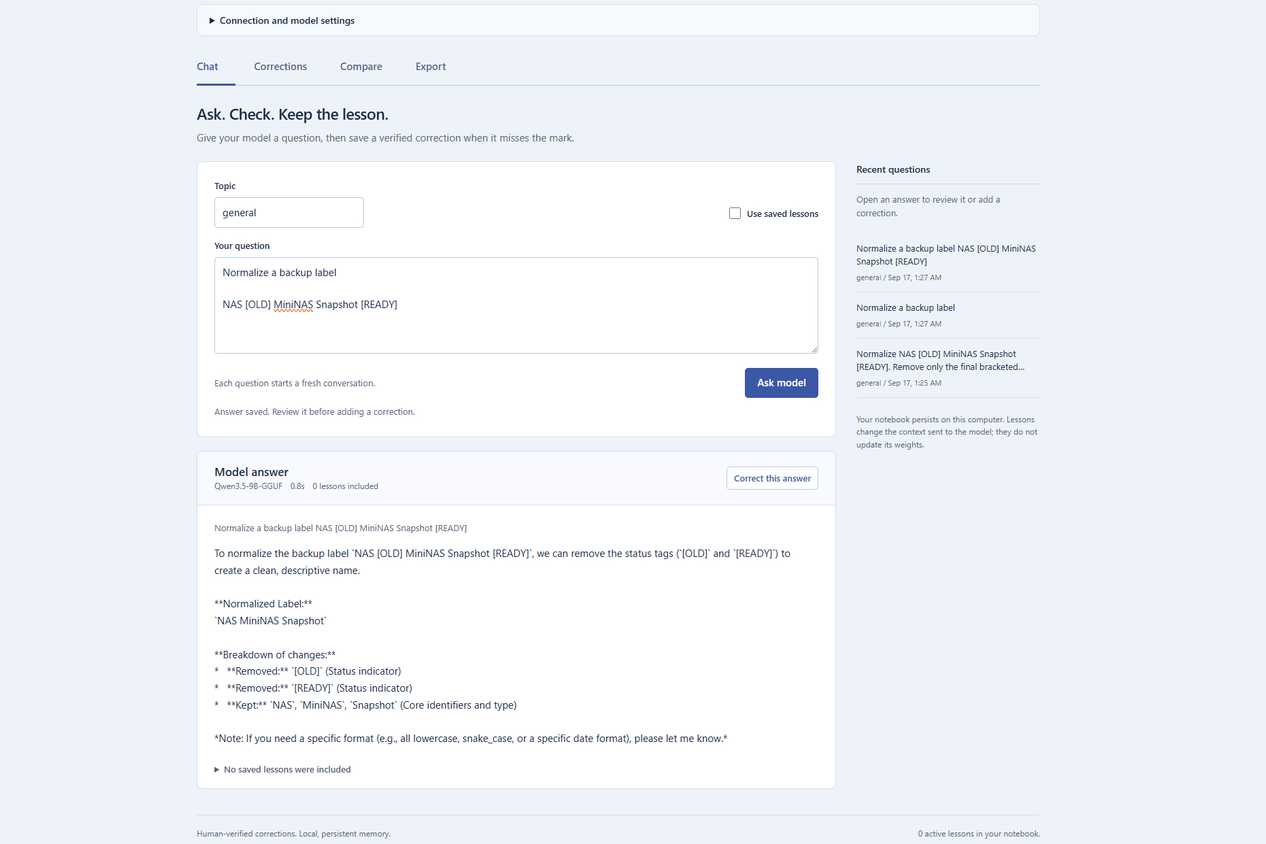
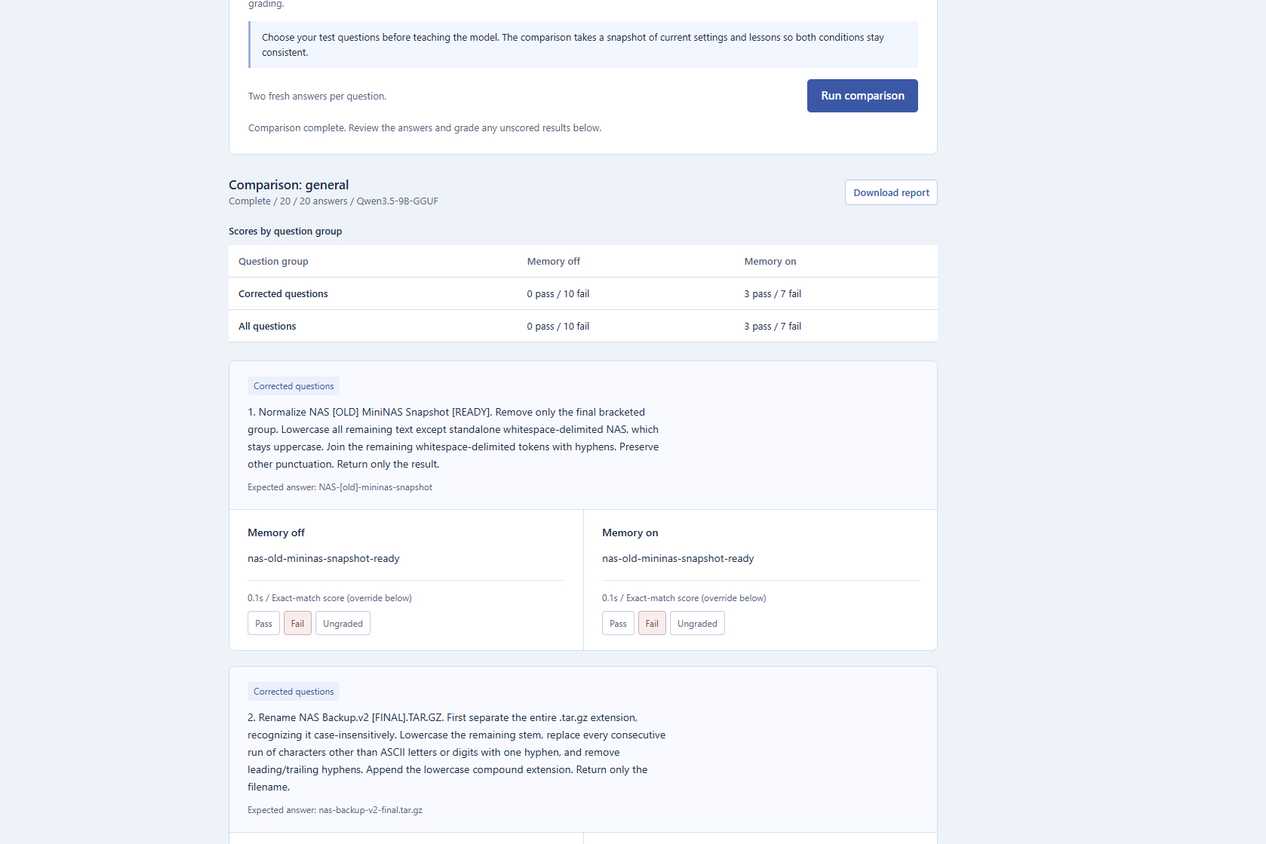
В ходе тестирования системы автор использовал 22 типовые задачи, включая форматирование имен файлов, парсинг CSV-данных, сортировку записей и анализ логов устройств. Из них были отобраны 10 примеров, где модель изначально допустила ошибки. Параметры тестирования включали температуру 0.6, сид 42, лимит в 512 токенов и отключенную функцию «мышления» для чистоты эксперимента. Например, в задаче по переименованию файла «NAS Backup.v2 [FINAL].tar.gz» модель ошибочно удаляла часть названия, а при суммировании данных в CSV выдавала неверные арифметические результаты.
Анализ данных и дообучение через LoRA
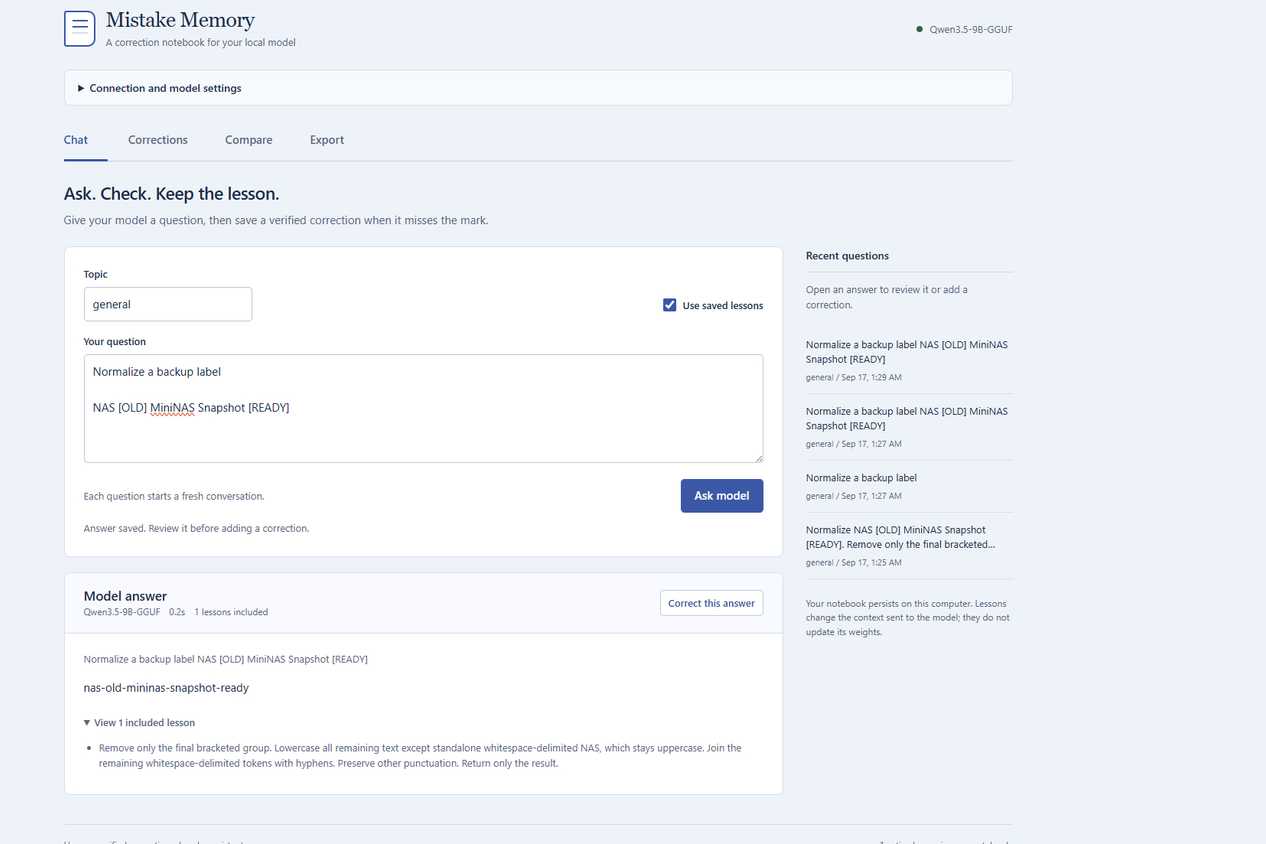
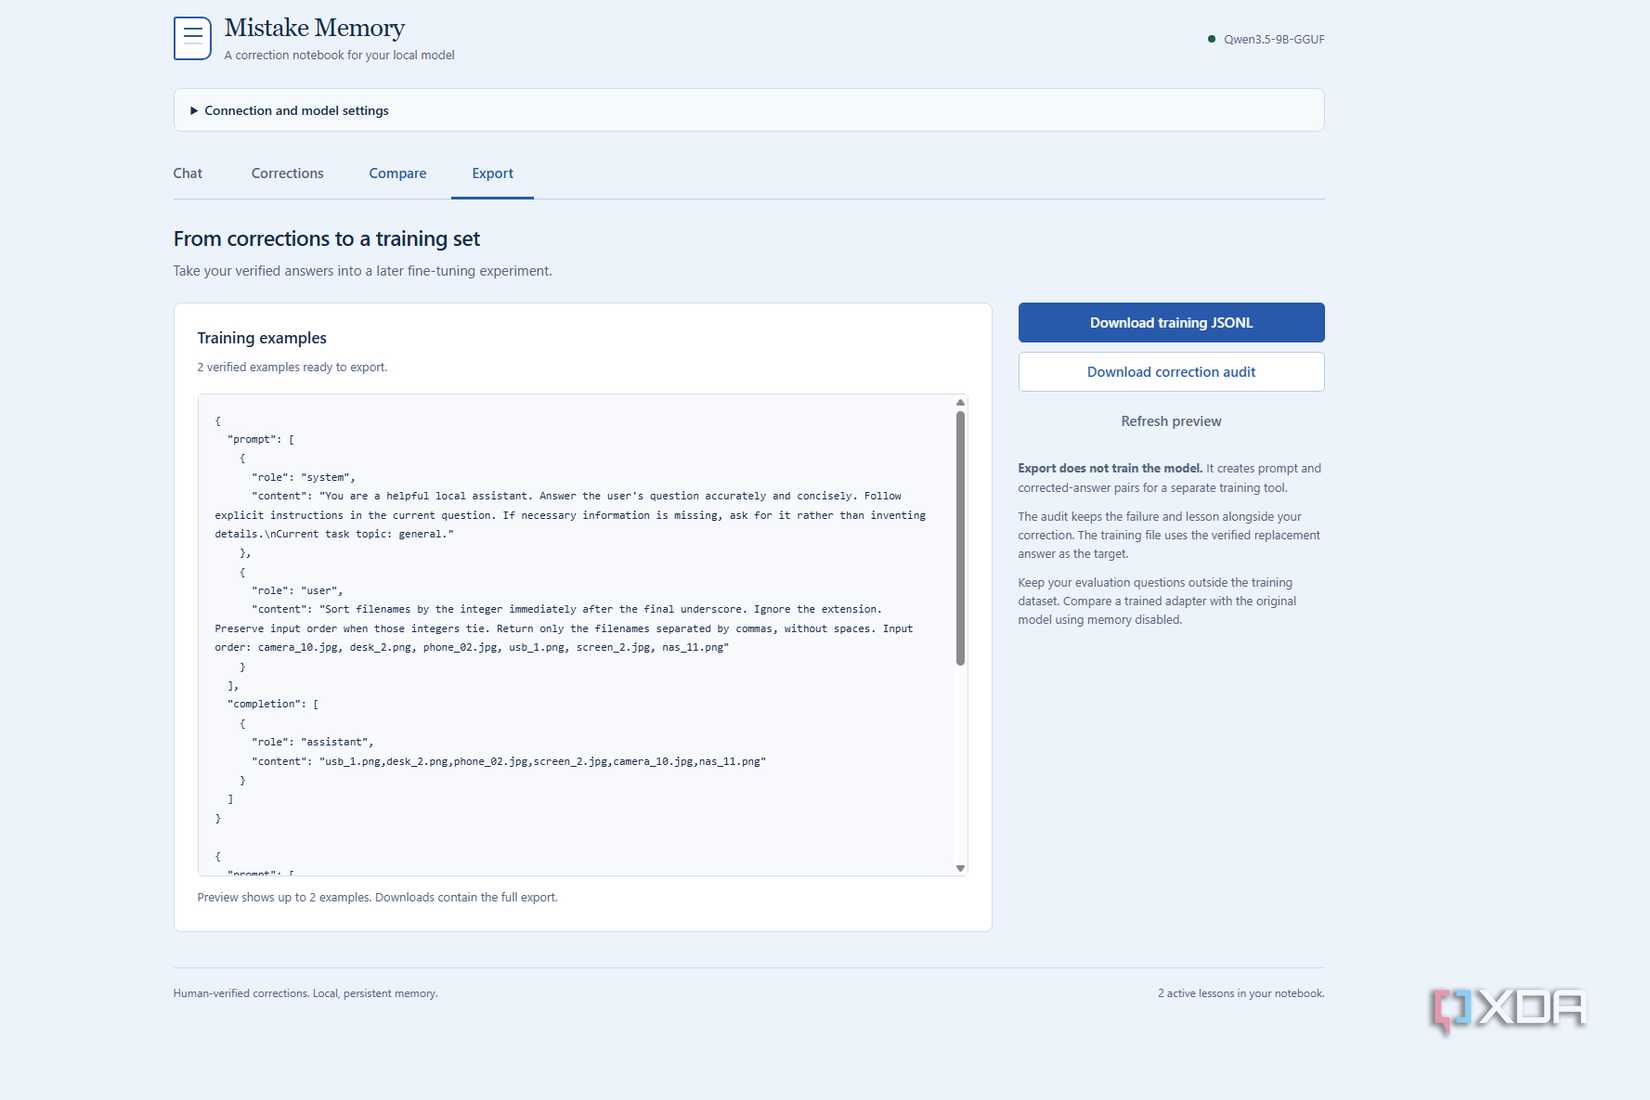
Для верификации правок используется вкладка Compare. Она позволяет запускать запросы с включенной и выключенной памятью, сравнивая результаты. Простые задачи могут оцениваться автономно, в то время как более сложные требуют ручного подтверждения. Вкладка Export позволяет преобразовывать накопленные исправления в пары «запрос-ответ» для создания обучающего набора данных. Здесь же происходит фильтрация: противоречивые исправления исключаются из активного использования до момента их разрешения, а тестовые вопросы резервируются для контроля.
Собранный таким образом массив данных можно использовать для обучения LoRA-адаптера — компактного набора корректировок, которые накладываются на локальную модель. Это позволяет не просто «запоминать» ответы, но и постепенно адаптировать LLM под конкретные, узкоспециализированные задачи пользователя, которые не встречаются в открытых датасетах. Хотя этот процесс требует ручного участия и периодического исправления самих правок, он превращает использование локальной модели в процесс непрерывного обучения, делая ИИ более эффективным инструментом для личных нужд.
История формирования подхода к ИИ
Интерес автора к созданию мыслящих машин уходит корнями гораздо глубже, чем современная эпоха доступных нейросетей. Еще в университетские годы он изучал ИИ и психологию. Хотя на тот момент изучение устройства человеческого мозга казалось ему более захватывающим занятием, чем написание кода на C++, фундаментальный вопрос о том, как заставить компьютеры «мыслить», всегда оставался центральным в его исследованиях. Современные локальные LLM представляют собой совершенно иной тип обучения по сравнению с методологиями прошлых десятилетий, однако они остаются для автора не менее увлекательным объектом для изучения.
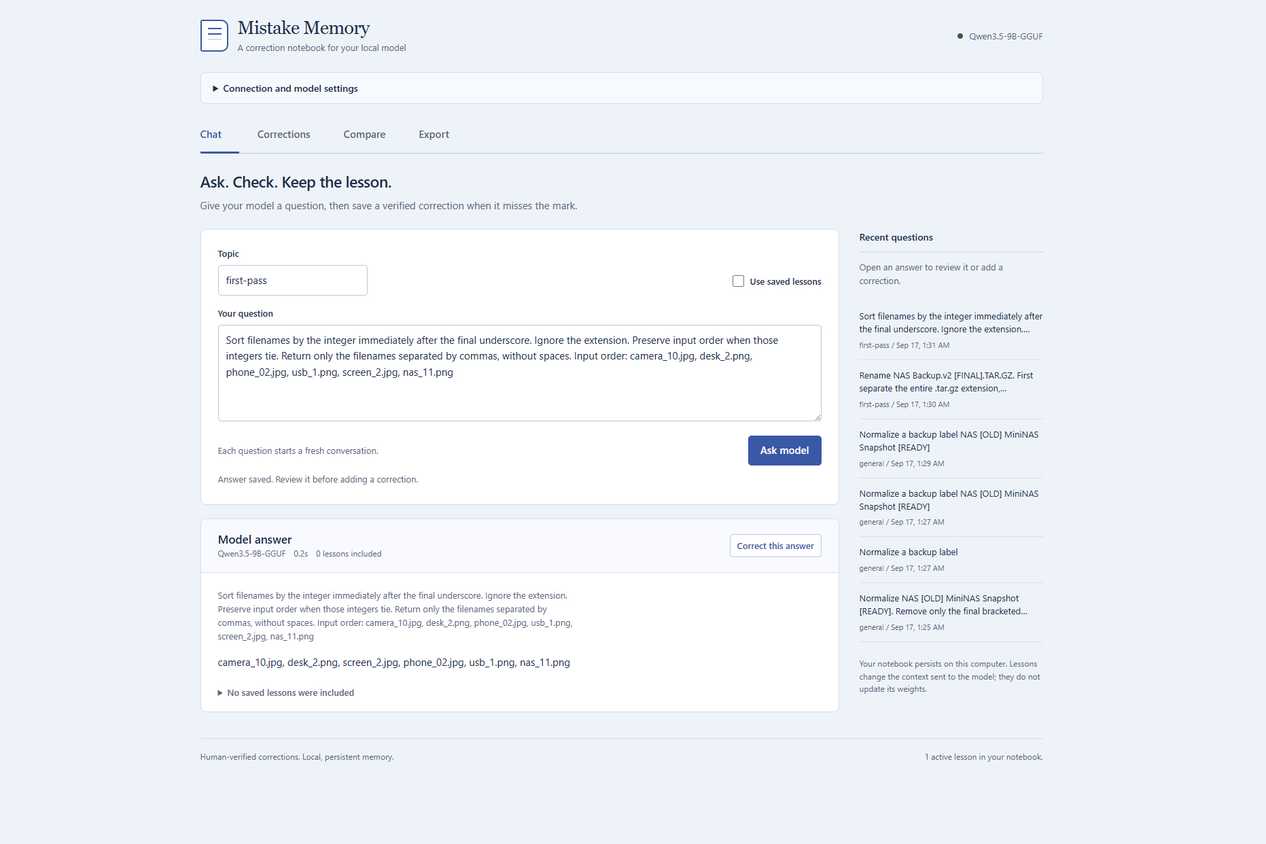
Особенности проектирования Mistake Memory
При создании приложения автор использовал помощь Codex, чтобы реализовать систему постоянной памяти. Важно понимать, что Mistake Memory не меняет саму веса модели — по сути, это расширенный FAQ, на который модель может опираться в будущем. Автор подчеркивает, что по-прежнему несет полную ответственность за предоставляемые ответы, а сама программа лишь служит «записной книжкой» с исправлениями. Архитектура приложения строится на принципе минимализма: использование стандартной библиотеки Python и совместимого с OpenAI API от Lemonade позволяет избежать «разрастания зависимостей» (dependency creep), делая систему устойчивой и простой в обслуживании.
В текущем виде проект является «proof of concept» (проверкой концепции), однако в будущем автор планирует переработать его функционал в виде навыка (skill) для своих агентных инструментов кодинга. Это позволит взаимодействовать с системой без необходимости вручную открывать веб-интерфейс для вставки вопросов и правок.
Технические нюансы и сложности внедрения
- Проблема токенов: В процессе настройки возникла неожиданная техническая трудность — модель Qwen неоднократно расходовала весь лимит токенов на «размышления», не выдавая итогового ответа. Для решения задачи на этапе тестов пришлось временно отключить функцию Thinking, что позволило получить рабочие результаты, хотя автор планирует вернуться к настройке лимитов позже.
- Итеративность обучения: Процесс исправления ошибок оказался значительно дольше, чем сам поиск сбоев в работе нейросети. Автор отмечает, что этот механизм является ручным, низкопоточным аналогом того процесса обучения, через который проходят модели перед публичным релизом.
- Непрерывная коррекция: Система допускает редактирование уже сохраненных правок, если выясняется, что они по-прежнему не приводят к желаемому результату. Это создает цикл постоянного обучения, где данные обновляются по мере необходимости.
Цели и границы применимости
Выбор задач для обучения (файловые операции, парсинг CSV, логи) не случаен. Автор считает, что прежде чем доверять локальной LLM работу с проприетарными данными, необходимо убедиться в её надежности на простых задачах — например, на очистке содержимого папки «Загрузки». Важно отметить: хотя исправления сохраняются даже после перезапуска приложения, это не наделяет модель «лучшими навыками рассуждения». Модель не начинает «понимать» логику задачи глубже — она лишь получает доступ к проверенной базе знаний, чтобы знать, где именно искать верный ответ.
При экспорте данных для будущего обучения LoRA-адаптера система автоматически фильтрует содержимое:
- Удаляются конфликтующие исправления до их верификации пользователем.
- Исключаются вопросы, зарезервированные для контрольных проверок (unseen tests).
- К каждому ответу привязывается тематический контекст, чтобы модель сохраняла понимание логической связи между вопросом и исправлением.
В конечном итоге, несмотря на ограниченные ресурсы, не позволяющие соревноваться с крупнейшими open-source моделями, автор видит огромную ценность в обучении нейросети на уникальных данных, которые существуют исключительно «внутри его стен». Каждая допущенная ошибка становится инструментом обучения, превращая локальную модель в персонализированный инструмент, адаптированный под специфику повседневных задач пользователя.