Анализ производительности нейросети Qwen 3.8 27B
Выпущенная пару недель назад открытая ИИ-модель Qwen 3.8 27B от Alibaba мгновенно вызвала ажиотаж среди энтузиастов благодаря впечатляющим результатам тестов интеллекта для модели такого размера. При весе около 17 ГБ в четырехбитной квантованной версии и наличии встроенных мультимодальных возможностей, она привлекла внимание владельцев видеокарт RTX 5090, RTX 4090, RTX 3090, а также Radeon RX 7900 XTX, Radeon AI Pro R9700 и Arc Pro B70.
Возник закономерный вопрос: достигли ли мы уровня передовых моделей при использовании четырехбитной квантовки на одной видеокарте, и можно ли теперь отказаться от подписок на Claude или ChatGPT? Ответ, как и в случае с любым хайпом вокруг открытых моделей, сложнее, чем простое сравнение веса модели с объемом доступной видеопамяти (VRAM). Необходимо учитывать, достаточно ли памяти остается для контекста, и обеспечивает ли программный стек приемлемое время генерации первого токена и общую пропускную способность, а не только показатели на пустом контекстном окне.
Для оценки реальных требований Qwen 3.8 27B мы протестировали её на различных системах: от ПК с дискретными GPU до устройств с унифицированной архитектурой памяти (DGX Spark, Mac Studio, Ryzen AI Halo). В ходе тестов мы также проверяли работу встроенных функций многотокенового предсказания (MTP), если позволял объем VRAM.
Особенности работы на базе RTX 5090
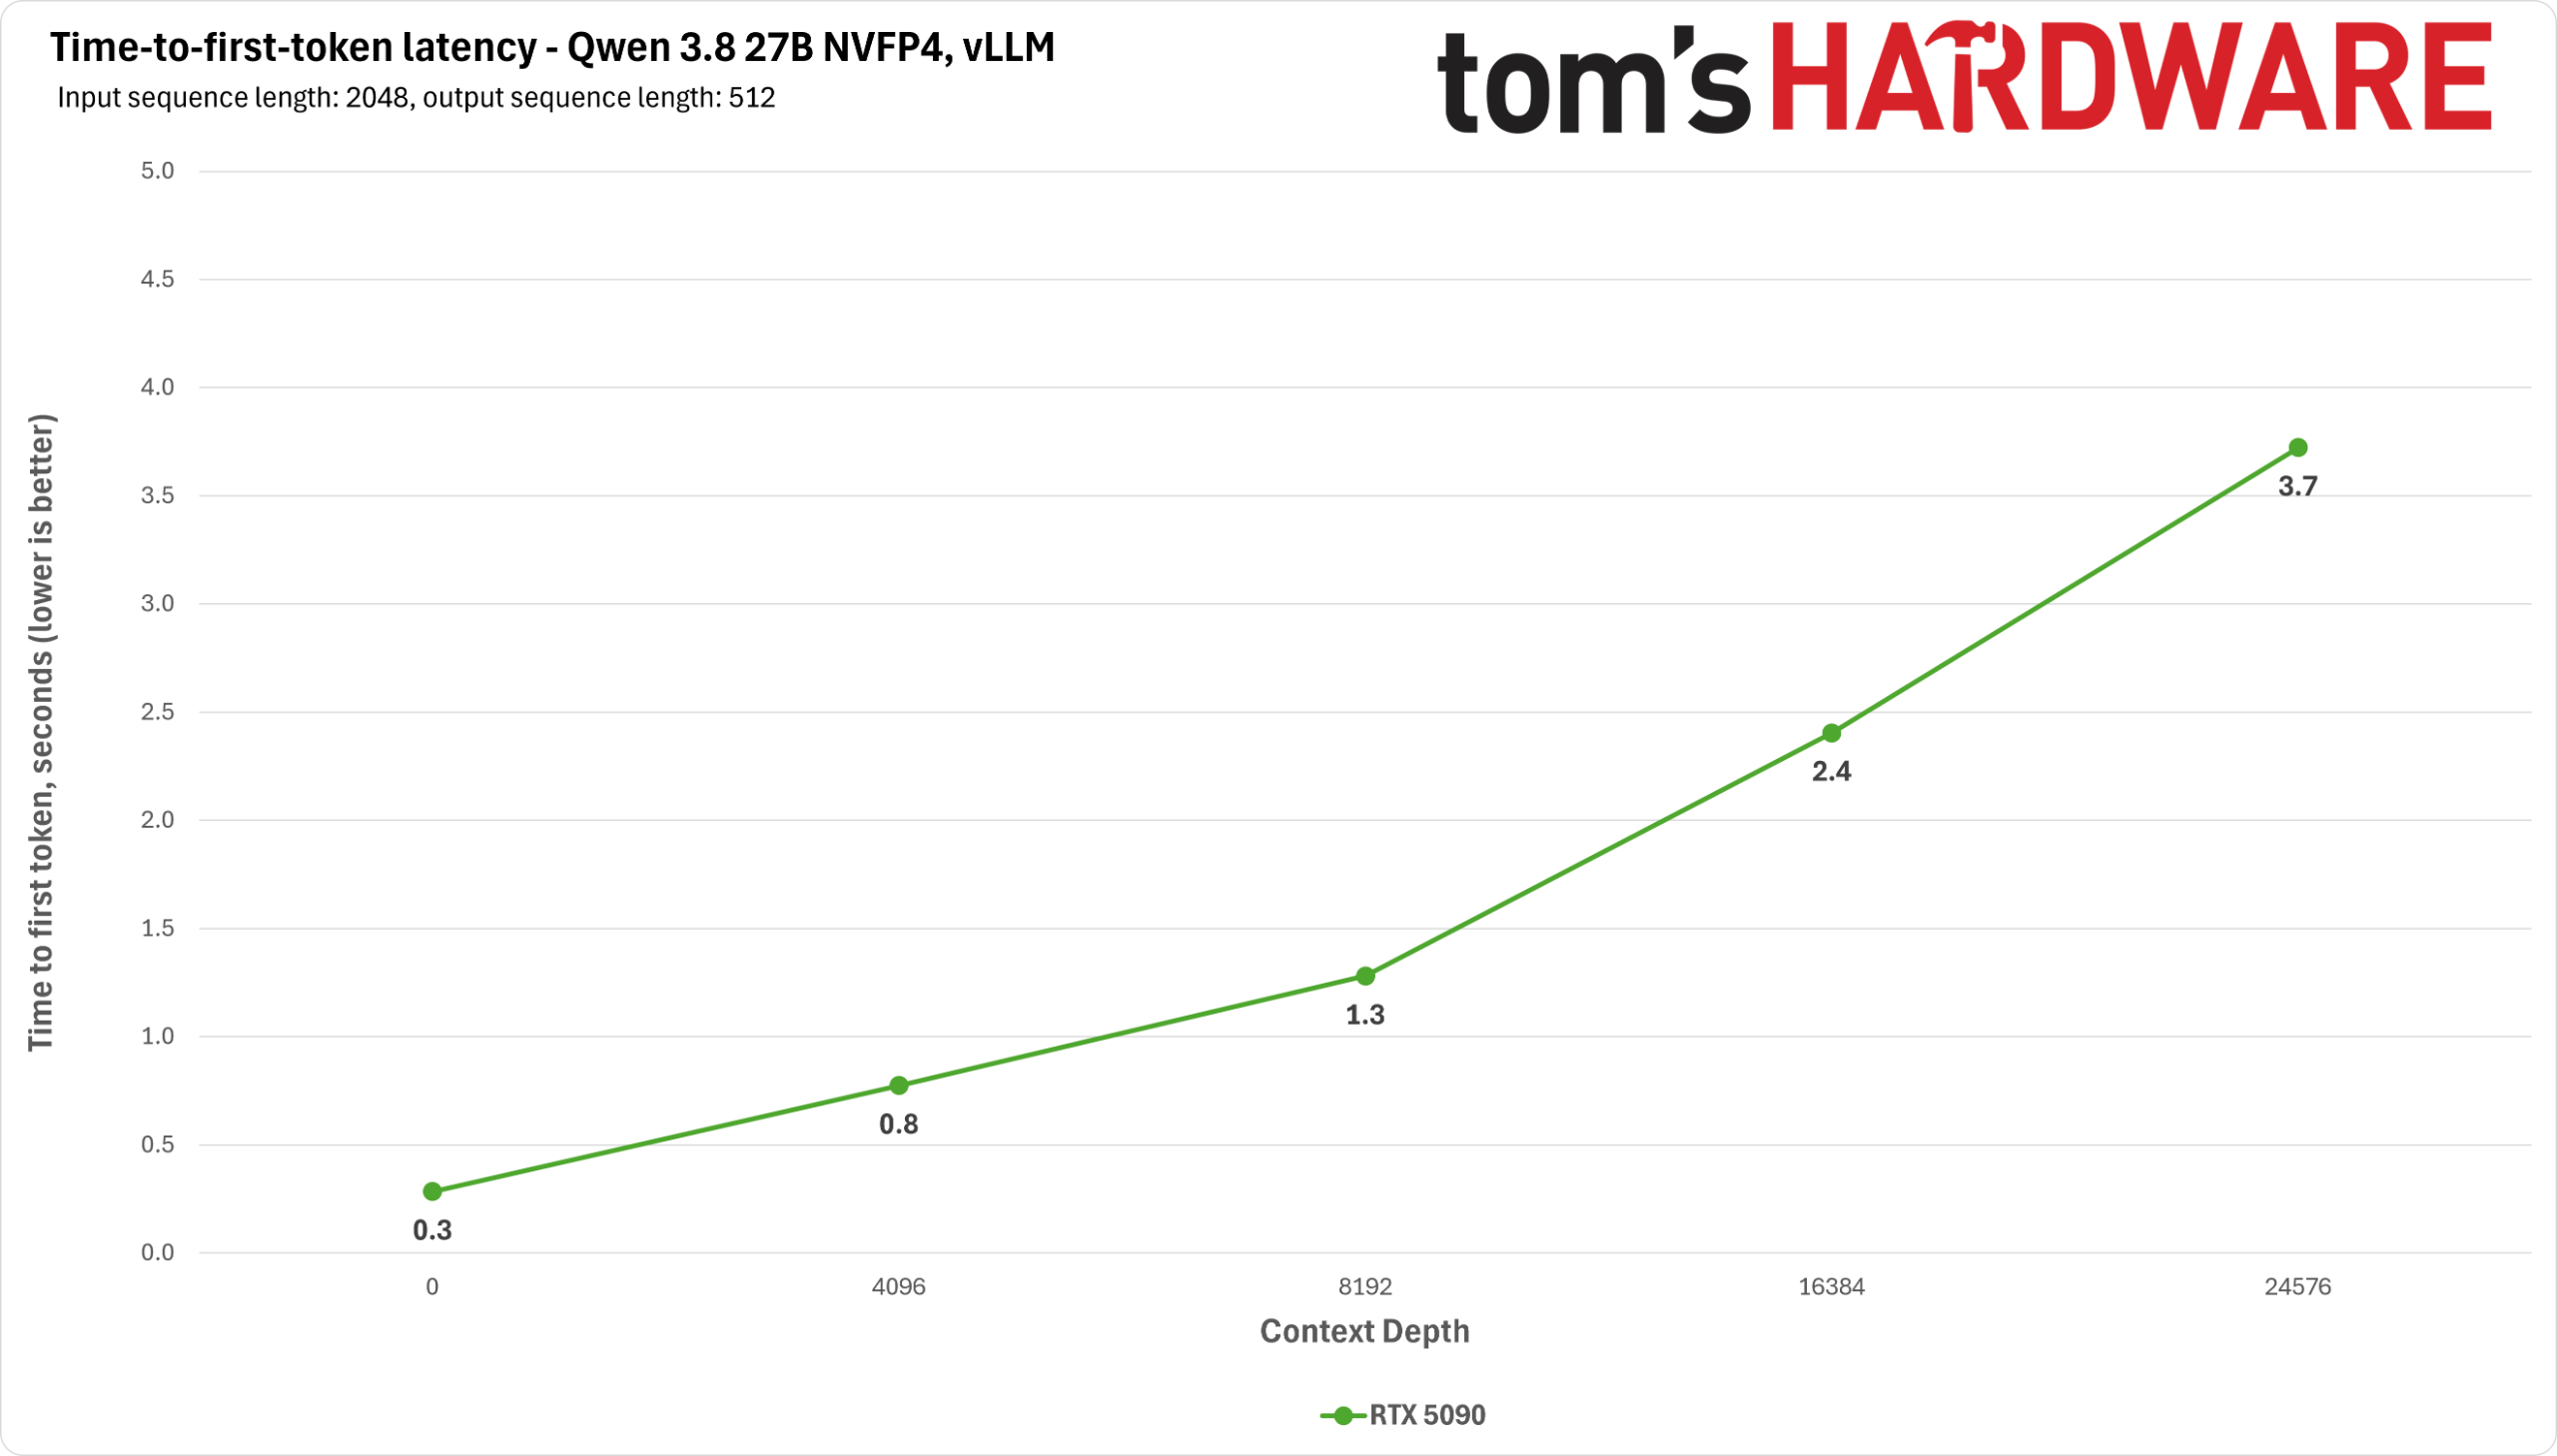
Мы начали тестирование с RTX 5090, чьи 32 ГБ памяти GDDR7 и пропускная способность 1,8 ТБ/с казались идеальными для плотных моделей (модели типа Mixture-of-experts более лояльны к железу вроде DGX Spark или Strix Halo из-за меньшего объема данных при выводе). В качестве базового метода использовалась последняя сборка llama.cpp с GitHub и квантованная версия модели от Unsloth.
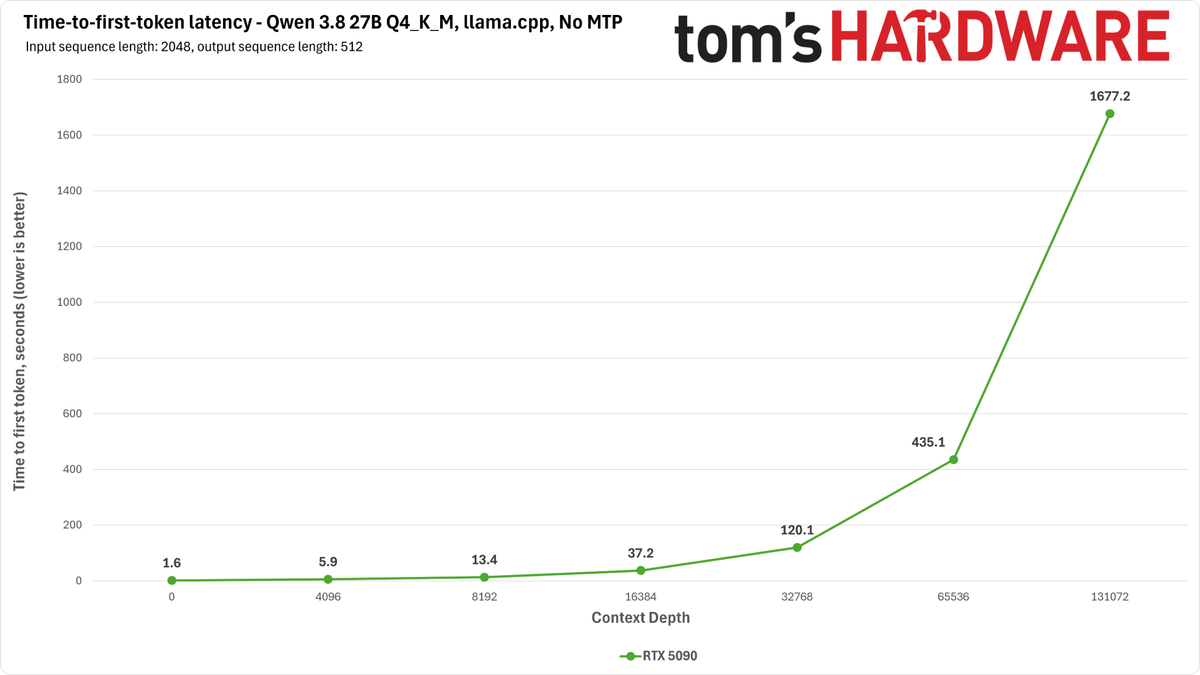
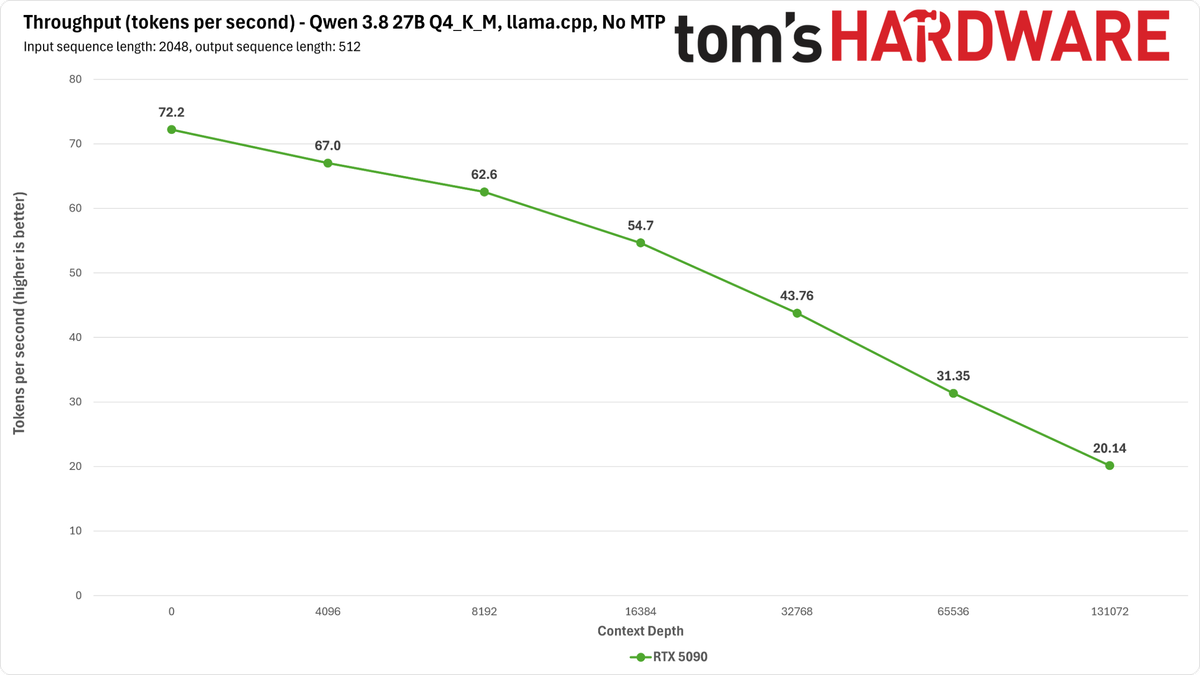
Однако возникли серьезные проблемы: хотя llama.cpp позволяет выделить полный контекст 262K, скорость обработки на RTX 5090 оказалась крайне низкой. Время генерации первого токена (TTFT) увеличилось примерно до 30 минут, а пропускная способность упала значительно ниже ожидаемой для столь мощной видеокарты. Очевидно, что на данный момент llama.cpp не является подходящим движком для этого железа.
Затем мы применили vLLM — движок промышленного уровня. Даже при 64 ГБ оперативной памяти нам потребовалось выделить еще 64 ГБ файла подкачки (swap), чтобы модель успешно загрузилась. Мы использовали конфигурации с одной и двумя RTX 5090, воспользовавшись предоставленной разработчиками vLLM квантовкой NVFP4.
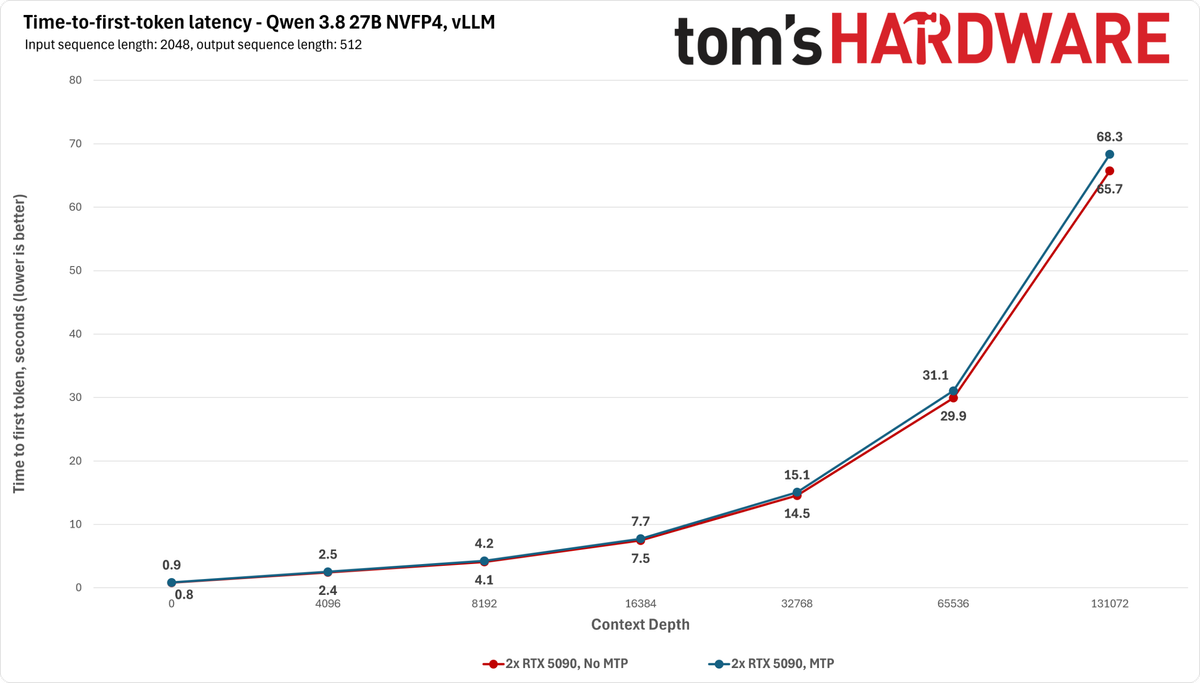
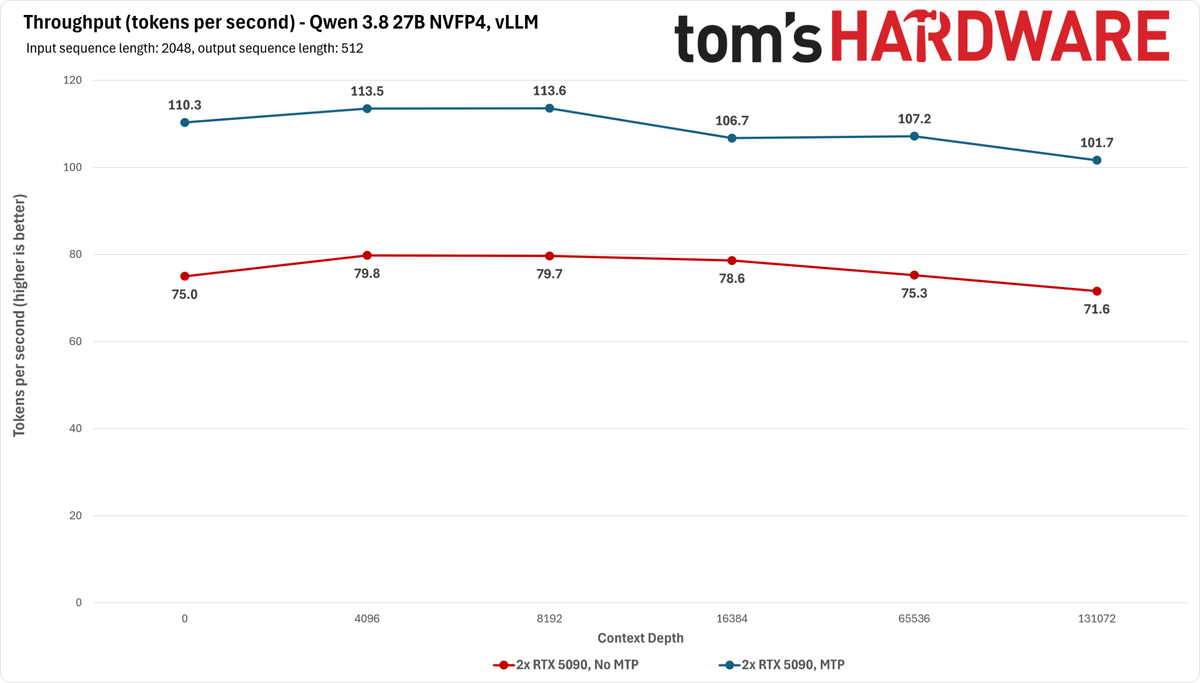
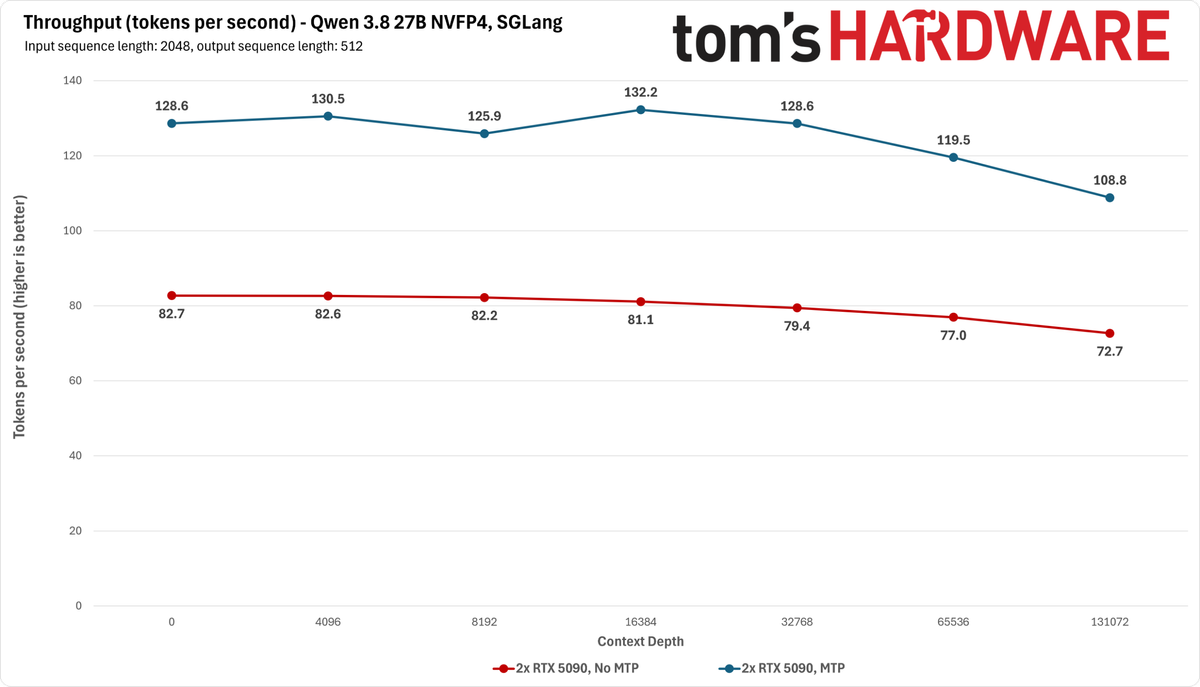
Использование одной RTX 5090 работает, но ограничивает контекст до 32K. Для полноценного использования 262K требуется либо карта с большим объемом памяти (например, RTX Pro Blackwell на 48 или 72 ГБ), либо пара RTX 5090. Кроме того, на одной карте невозможно включить функцию MTP, что оставляет базовую скорость декодирования на уровне 20 токенов в секунду — не самый впечатляющий результат для такой карты. При объединении двух RTX 5090 скорость декодирования в vLLM возрастает до 70–80 токенов в секунду по всей глубине контекста, а TTFT остается на приемлемом уровне, хотя нагрузка на предварительное заполнение (prefill) значительно возрастает.
Ускорение инференса: vLLM, SGLang и особенности работы с памятью
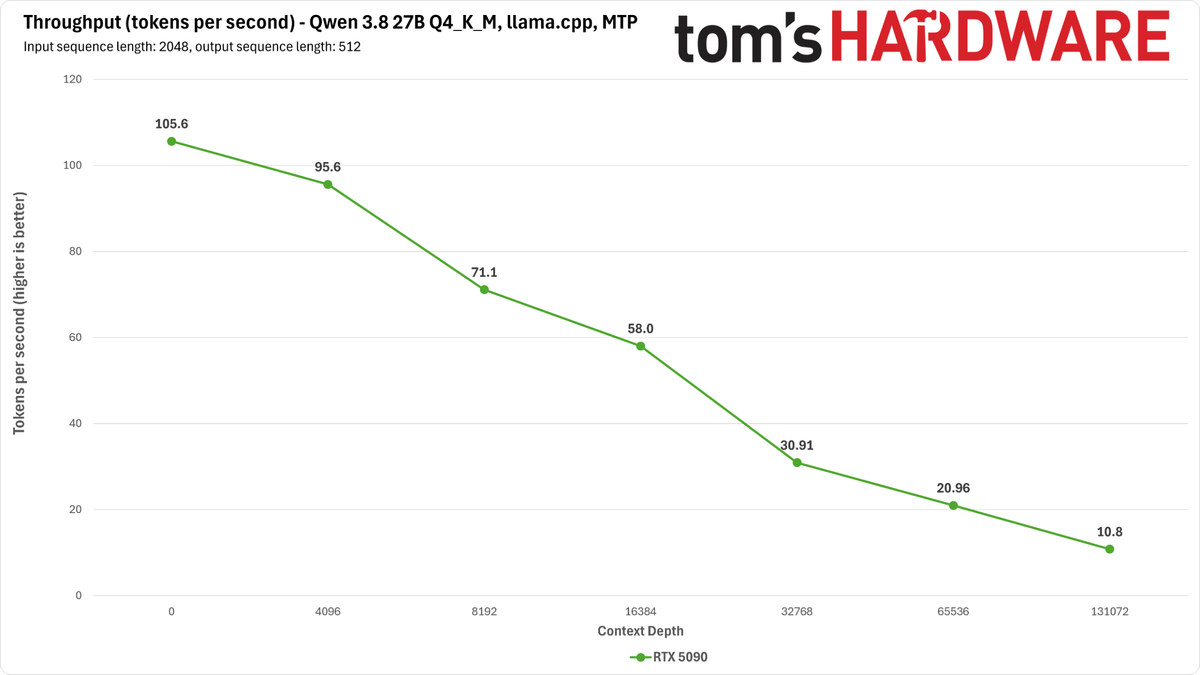
Мы можем добиться еще более высоких результатов. Активация MTP в vLLM позволяет достичь скорости декодирования на уровне 100–110 токенов в секунду, при этом замедление обработки промптов остается незначительным. Подобная конфигурация обеспечивает стабильную производительность с такой скоростью обработки входных данных, которая не заставляет пользователя сомневаться в корректности работы системы. Тем не менее, такая скорость закономерна, учитывая, что стоимость платформы с двумя RTX 5090, протестированной нами, на текущий момент превышает $13 000.
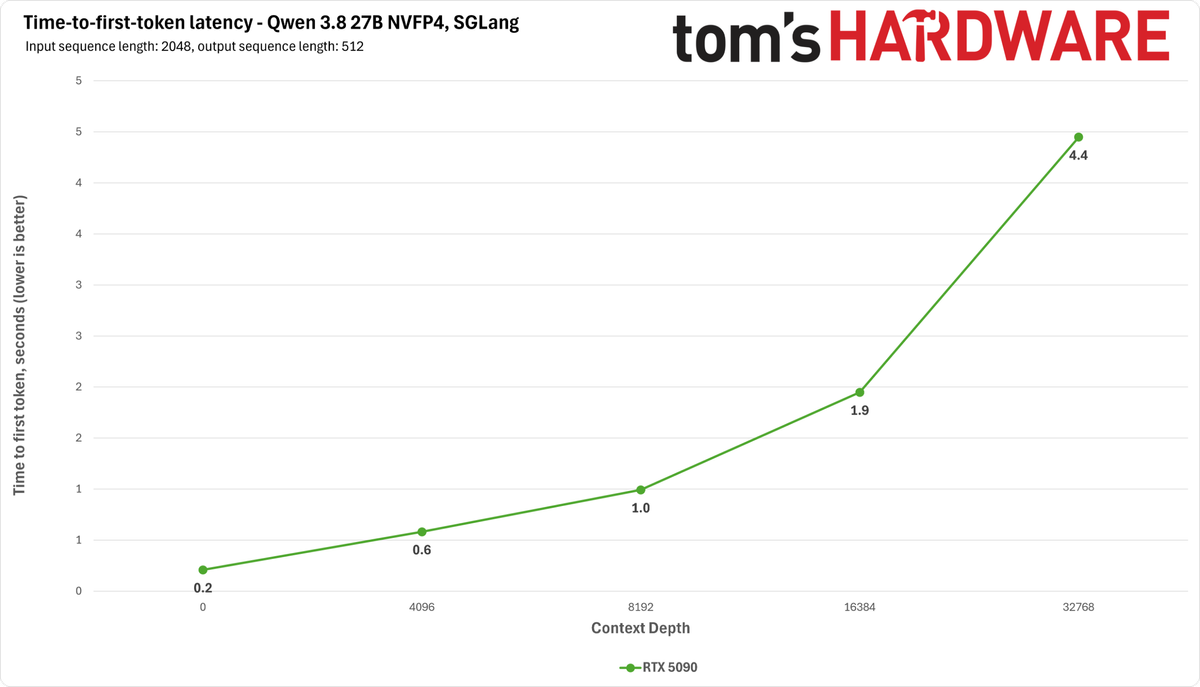
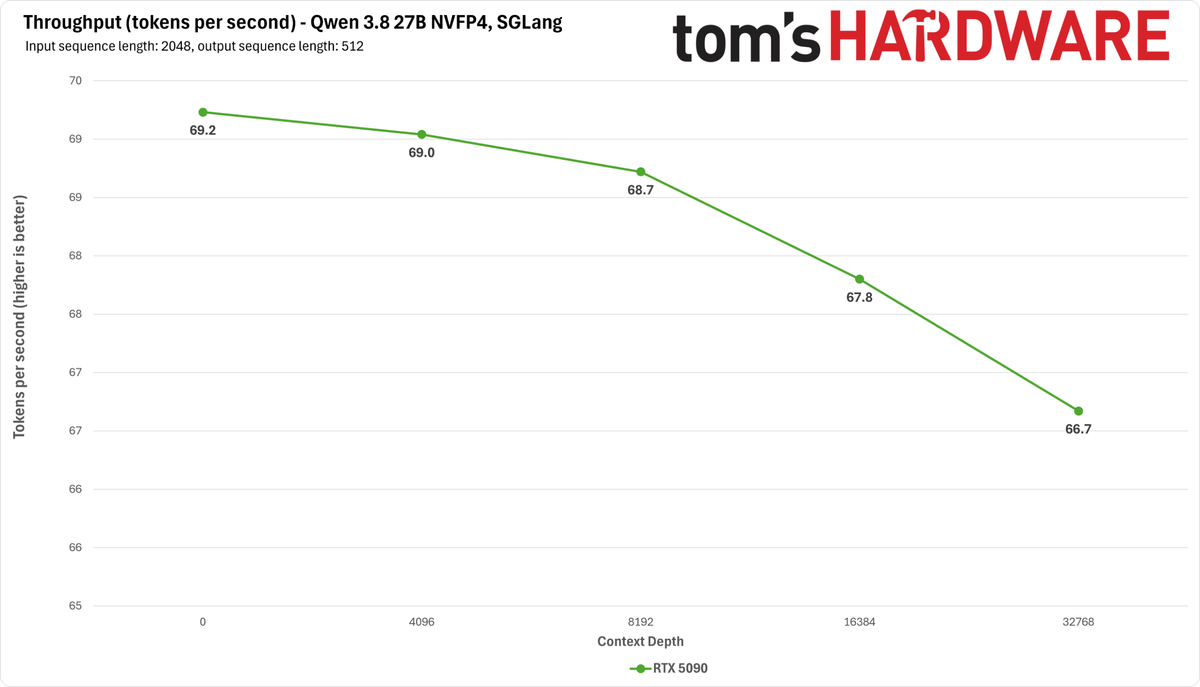
Мы также испытали движок инференса SGLang на RTX 5090 с конфигурациями, аналогичными тем, что применялись для vLLM. По неясным причинам SGLang на одной карте 5090 работает значительно быстрее — почти в 3 раза эффективнее «рецепта» vLLM для одной 5090, — а также позволяет задействовать чуть больший контекст (37 740 токенов). Однако для доступа к полному нативному окну в 262K по-прежнему требуется вторая видеокарта или альтернативное решение с большим объемом видеопамяти. Как и vLLM, SGLang поддерживает тензорный параллелизм между несколькими GPU, поэтому активация режима с двумя картами сводится к добавлению одного флага запуска. Аналогично vLLM, здесь доступны стратегии спекулятивного декодирования для повышения производительности вывода.
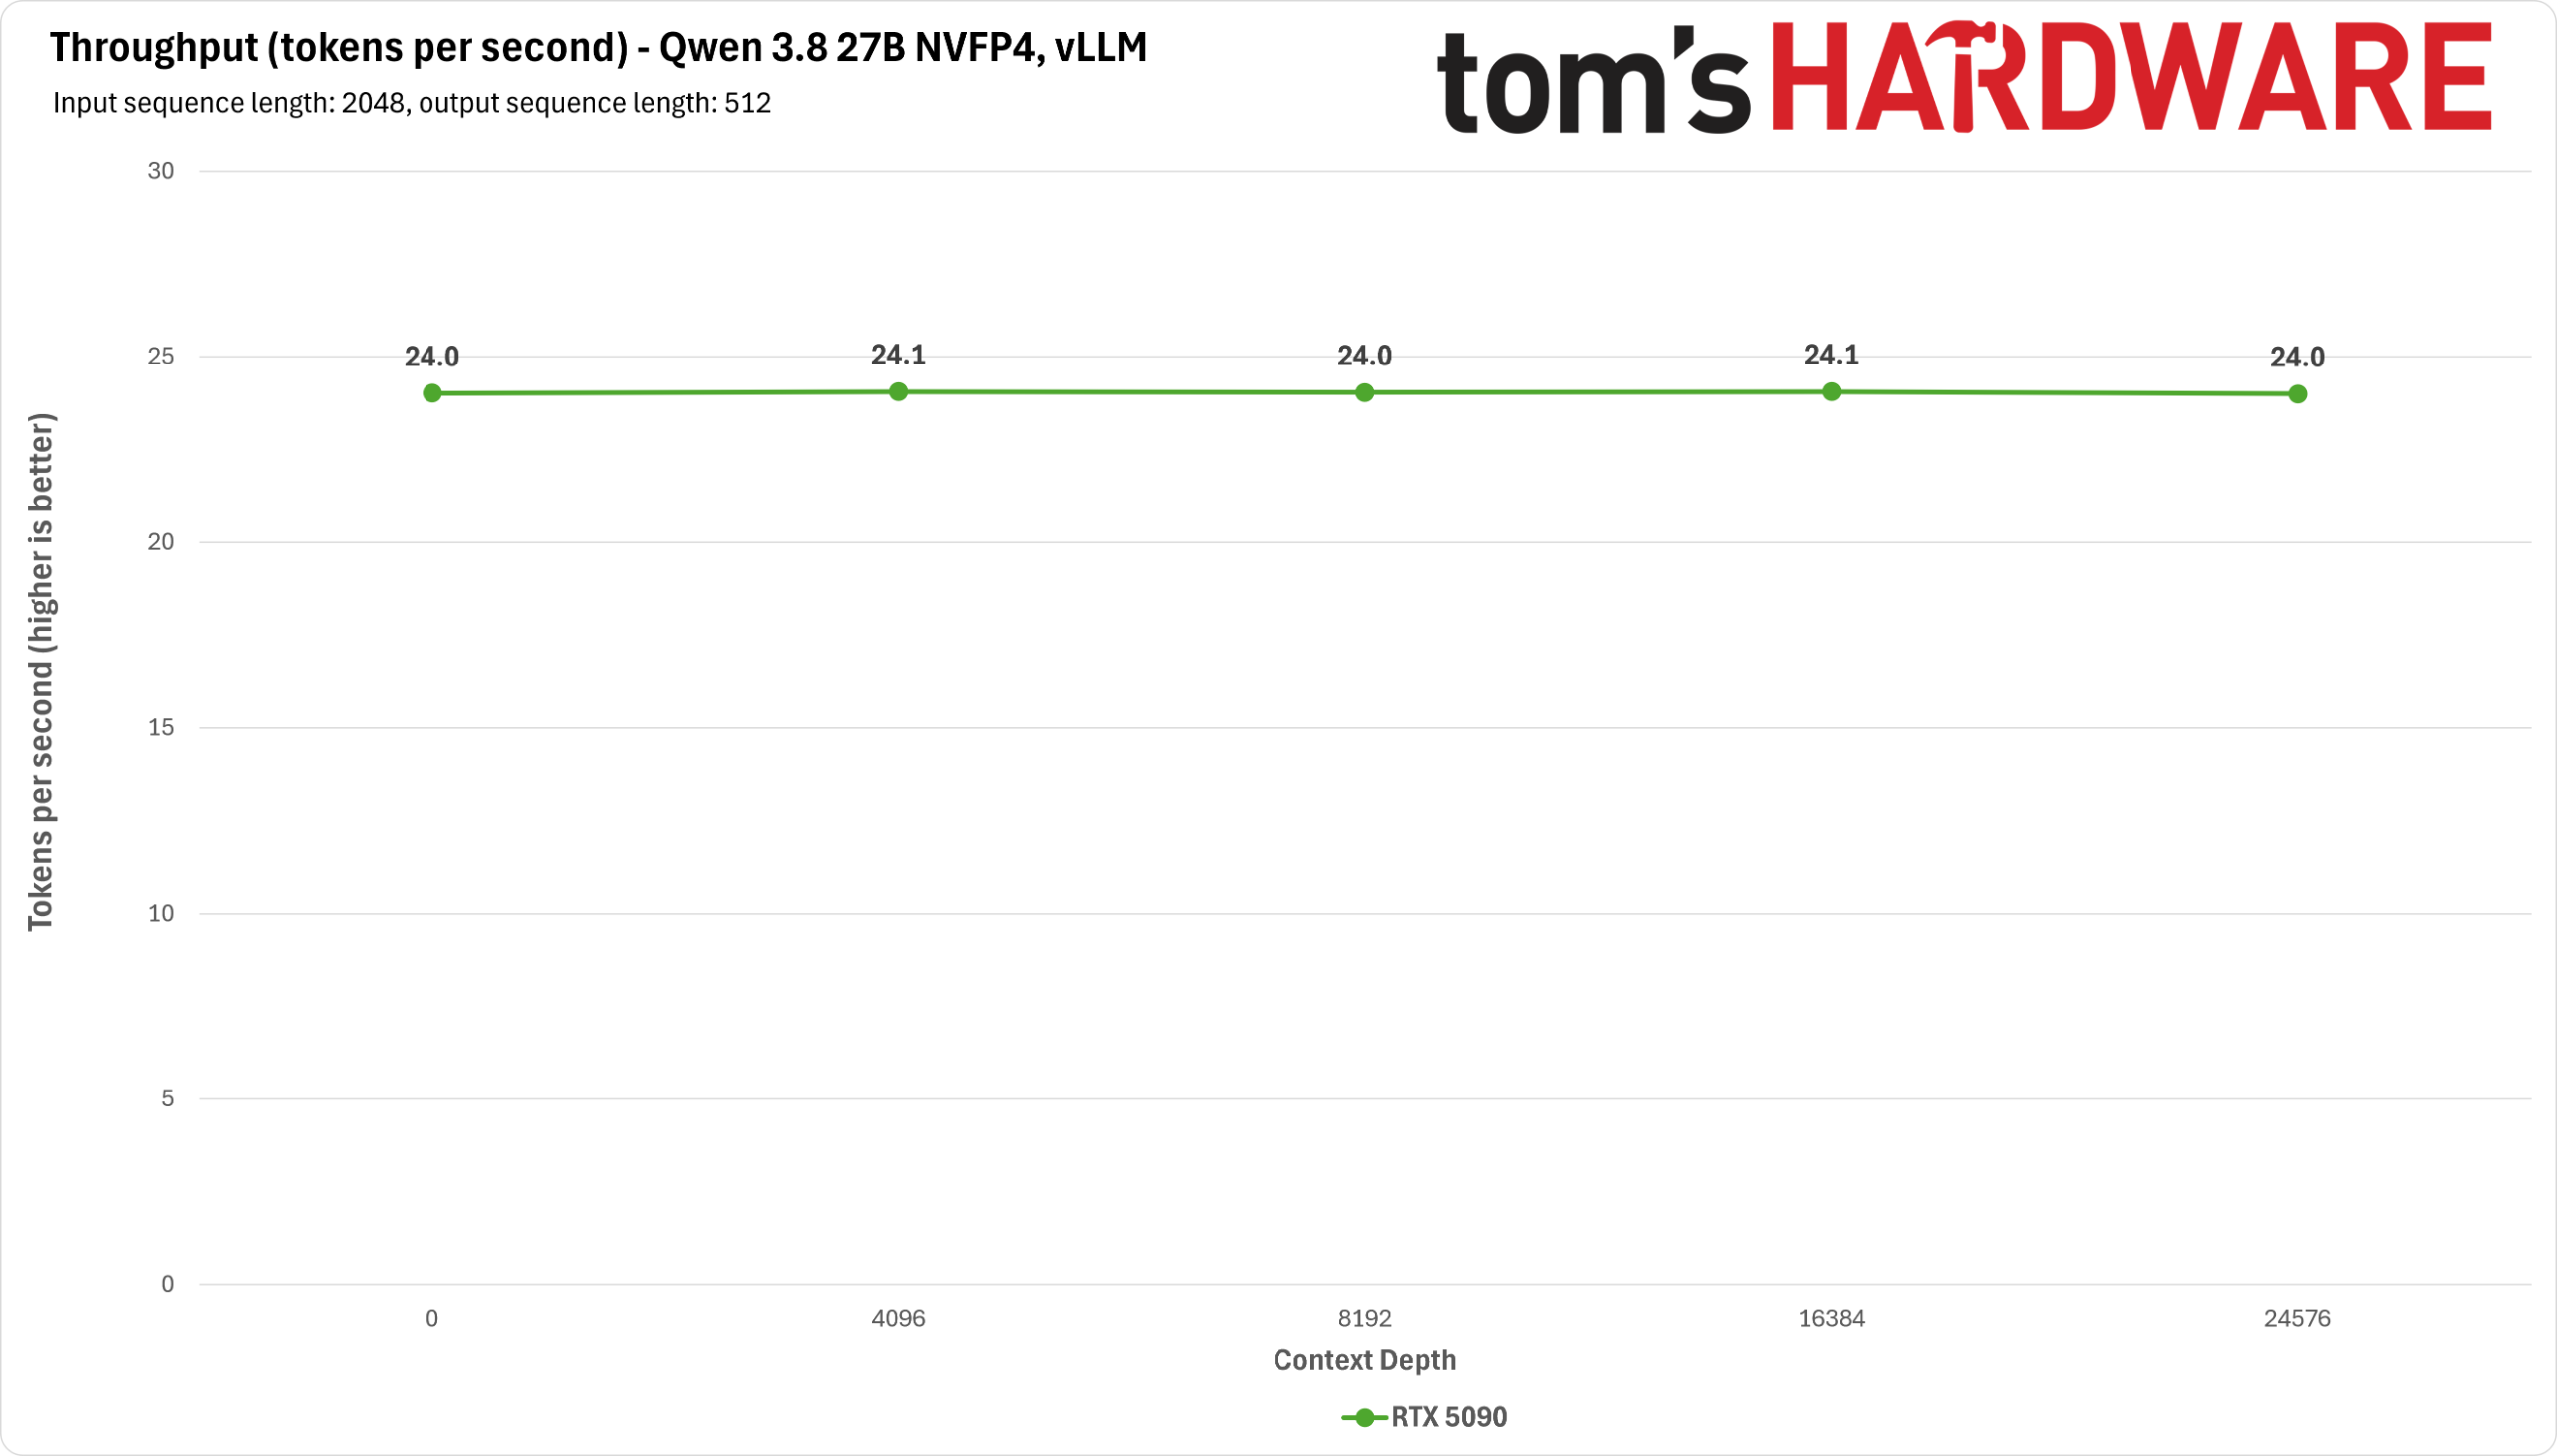
Главный вывод этого этапа тестирования: если у вас одна карта RTX 5090 и нет потребности в инференсе с длинным контекстом, вы вполне можете получить рабочую производительность на этой плотной модели. Но выбирать движок для запуска нужно внимательно. Если же вы хотите получить полный контекст, приемлемое время обработки промптов и высокую пропускную способность от Qwen 3.8 27B одновременно, в качестве базы вам потребуется видеокарта (или их набор) с объемом VRAM более 32 ГБ.
Производительность RTX 3090 и RTX 4090
Разобравшись с поведением RTX 5090, мы обратились к более старым потребительским картам, чтобы проверить, как они справляются с Qwen 3.8 27B. Карты RTX 4090 и 3090 с 24 ГБ памяти — неизменные фавориты среди энтузиастов локальных LLM благодаря большому объему VRAM и доступным ценам на вторичном рынке. Однако, как мы уже подчеркивали, возможность просто загрузить веса модели — это еще далеко не все.
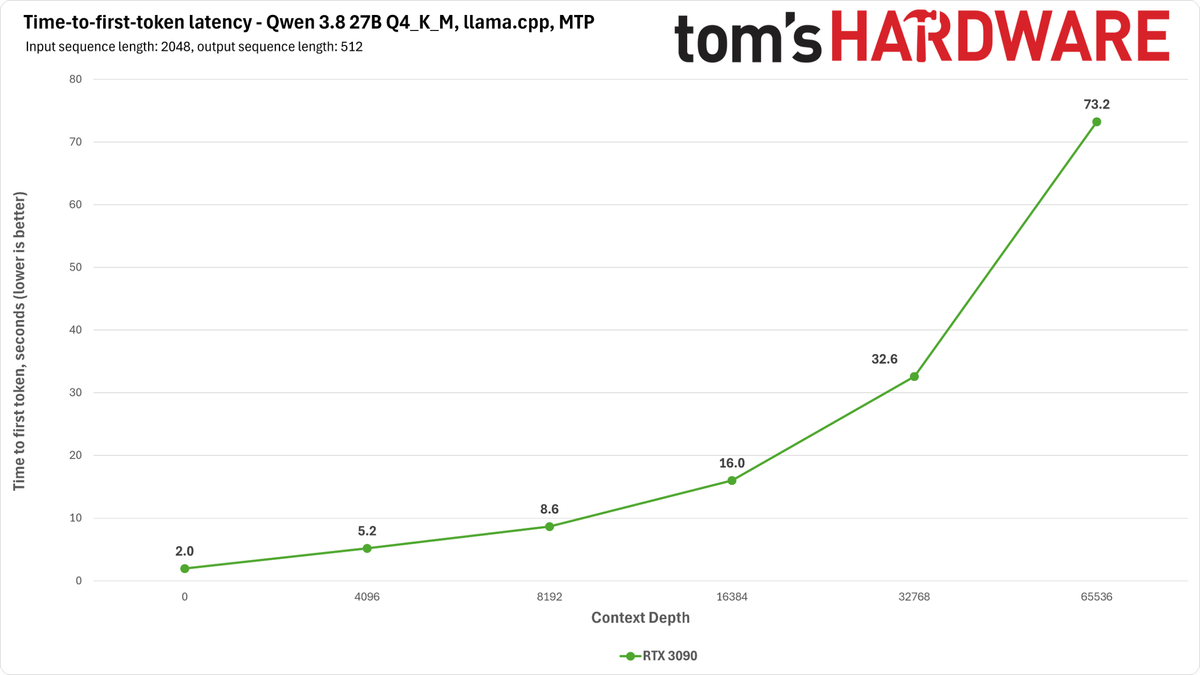
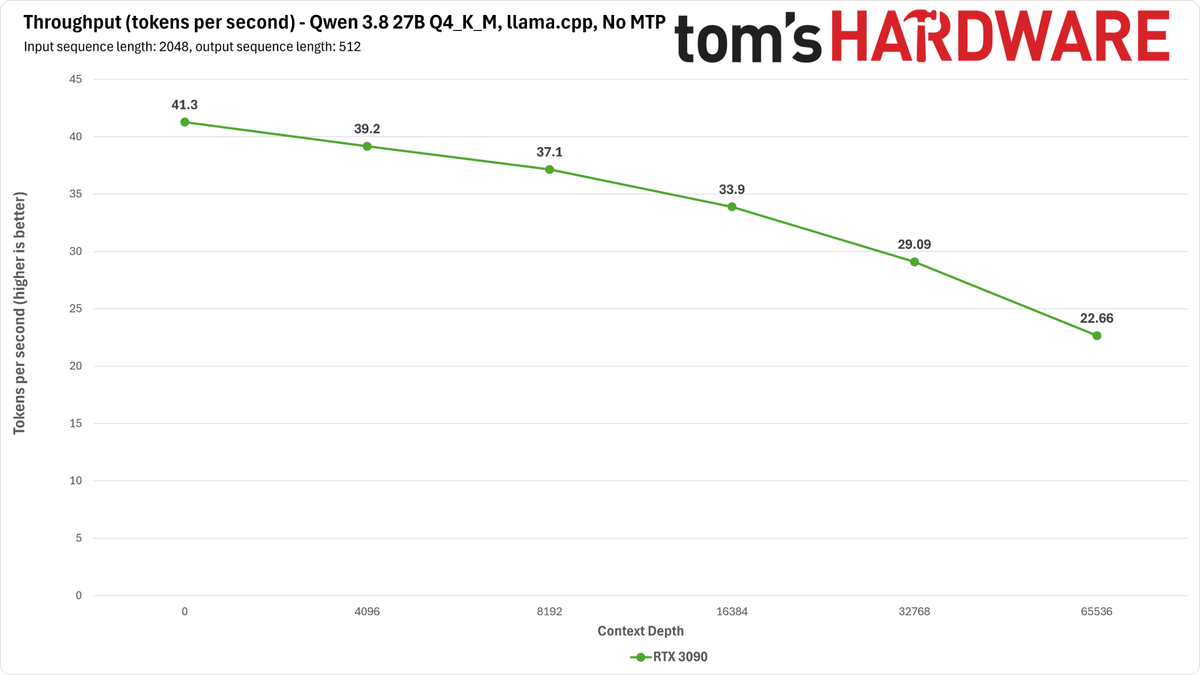
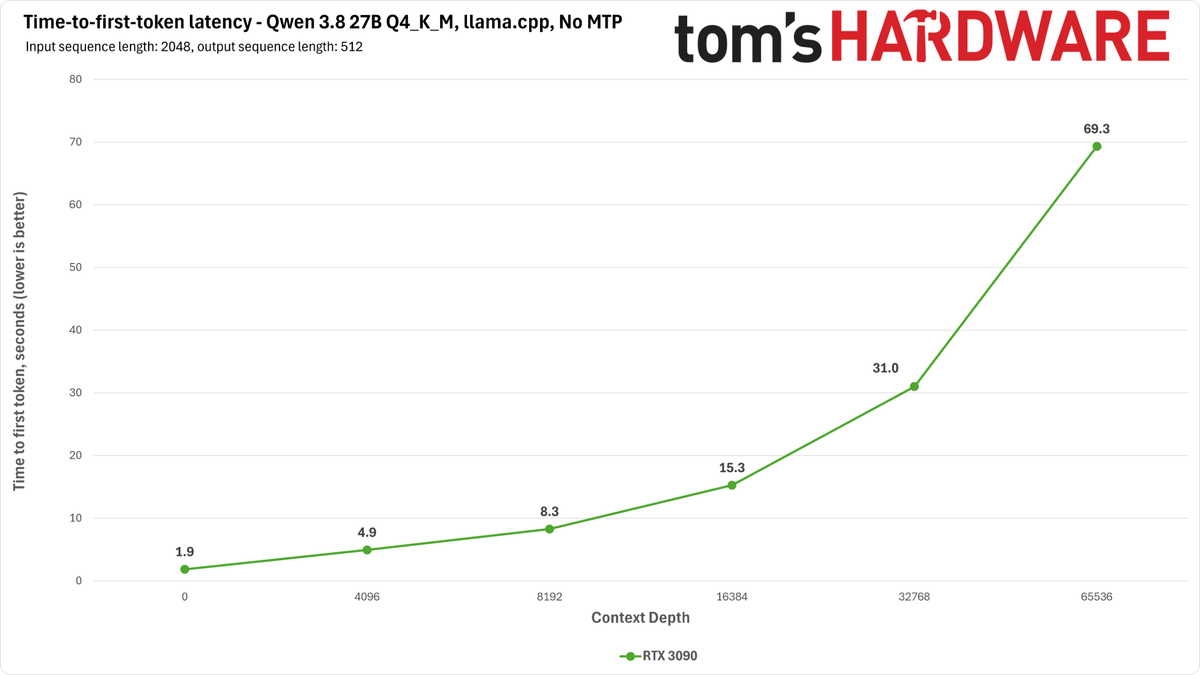
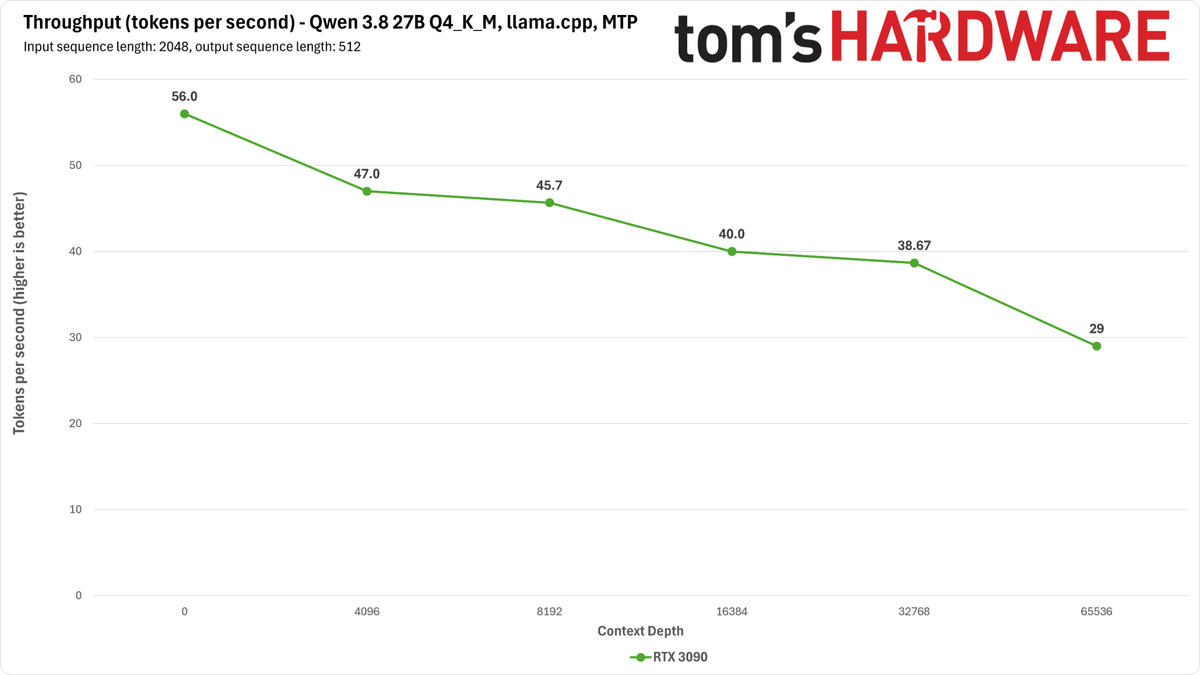
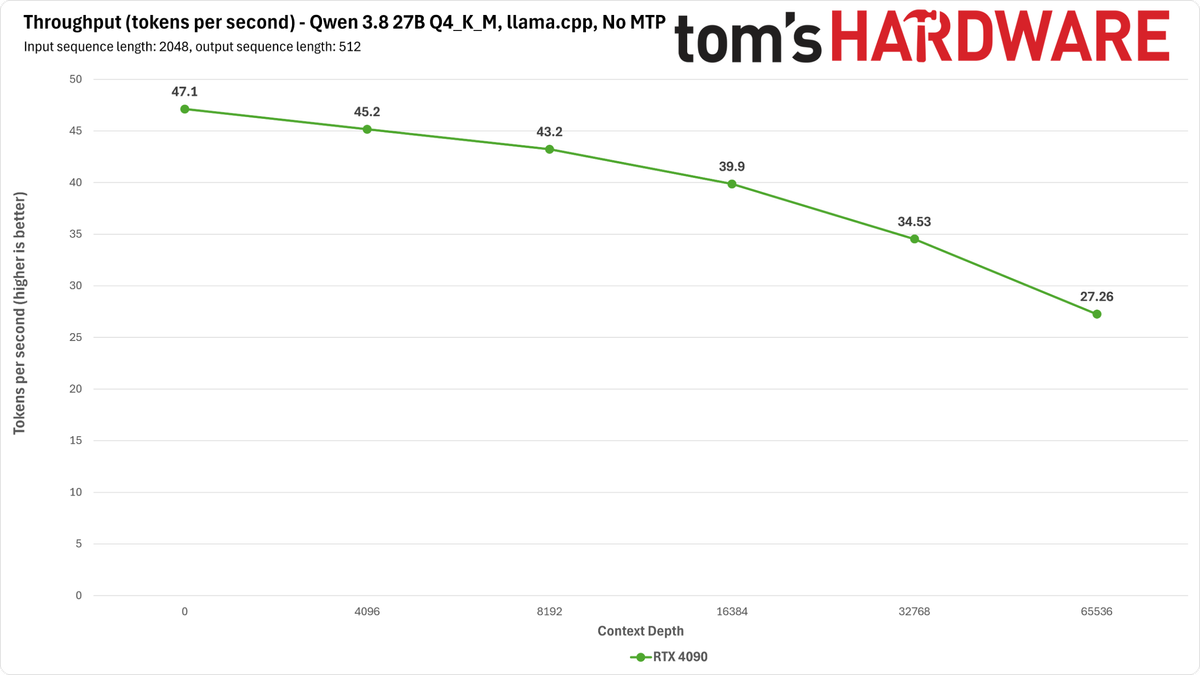
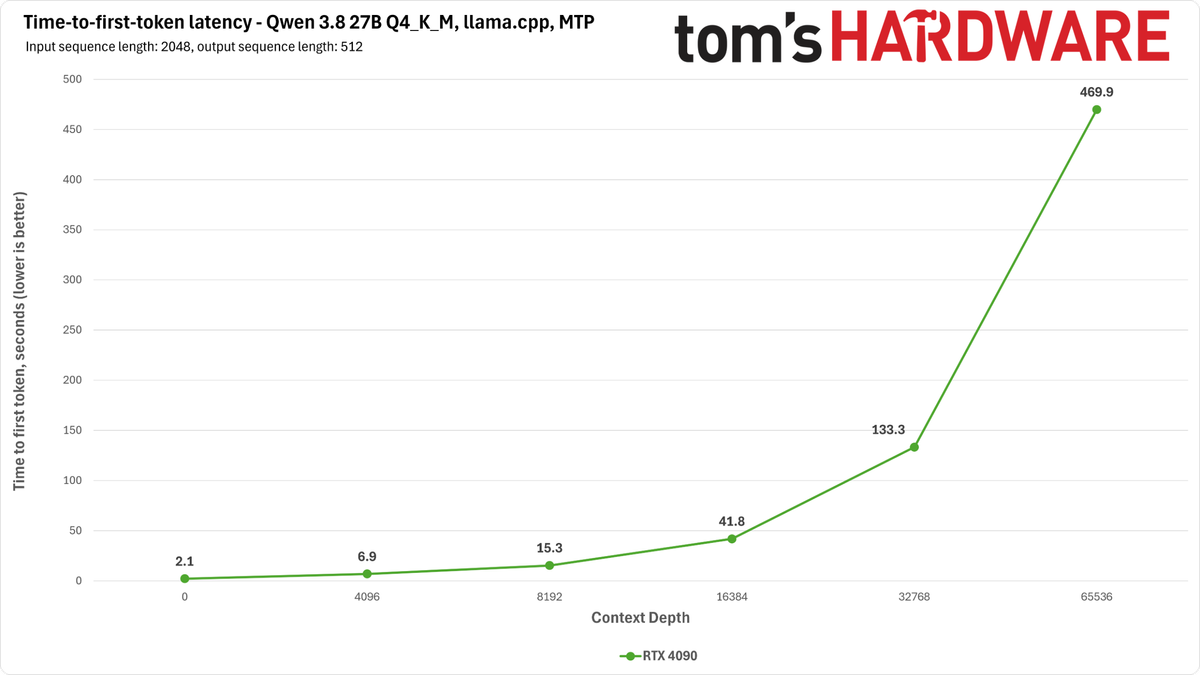
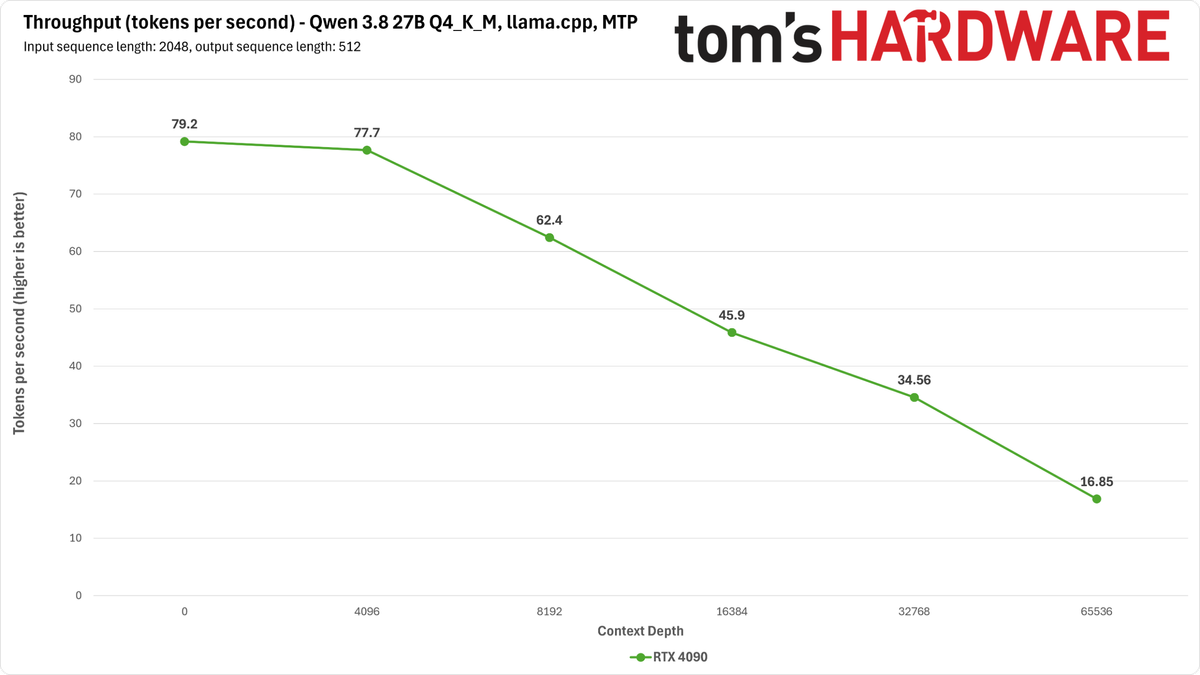
Эти карты успешно справляются с запуском Q4_K_M GGUF версии Qwen 3.8 27B через llama.cpp, но требуют использования квантования Q8_0 для KV-кэша, чтобы уместить результаты в ограниченный объем VRAM. Кроме того, необходимо ограничивать глубину контекста значениями значительно ниже нативного предела в 262K. Мы установили, что 112K токенов — это максимум, который можно получить до исчерпания видеопамяти. В отличие от 32-гигабайтной RTX 5090, которая обычно позволяет оставить запущенным графический менеджер окон Linux рядом с LLM, этим GPU для задач ИИ требуется каждый байт памяти, и ничего больше. Поэтому для работы с ними крайне желательно иметь отдельную видеокарту, если вы не используете систему в headless-режиме, который сам по себе может создать сложности с настройкой (например, при определении того, как материнская плата обрабатывает разделение линий PCIe и нумерацию основного графического устройства).
Как только вы преодолеете эти препятствия и запустите Qwen 3.8 27B, llama.cpp продемонстрирует на RTX 4090 тот же «обрыв» производительности на длинных контекстах, что мы видели у RTX 5090. Однако RTX 3090, что странно, эта проблема не затрагивает. Это указывает на наличие программной ошибки. У нас не было времени на глубокий анализ работы SGLang или vLLM на этих картах, но, учитывая нехватку контекста даже на RTX 5090, мы сомневаемся, что эти движки станут оптимальным способом запуска модели на 24-гигабайтных картах, если только вы не располагаете несколькими картами 3090 или 4090, накопленными ранее.
Производительность DGX Spark и Apple Mac Studio
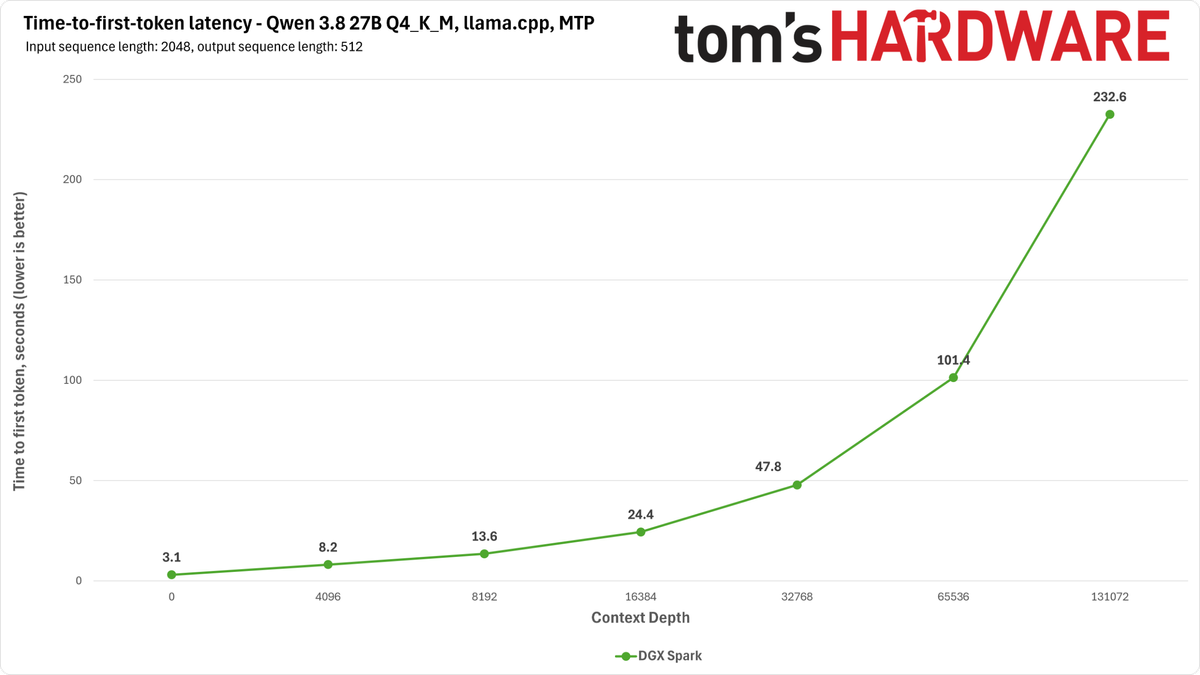
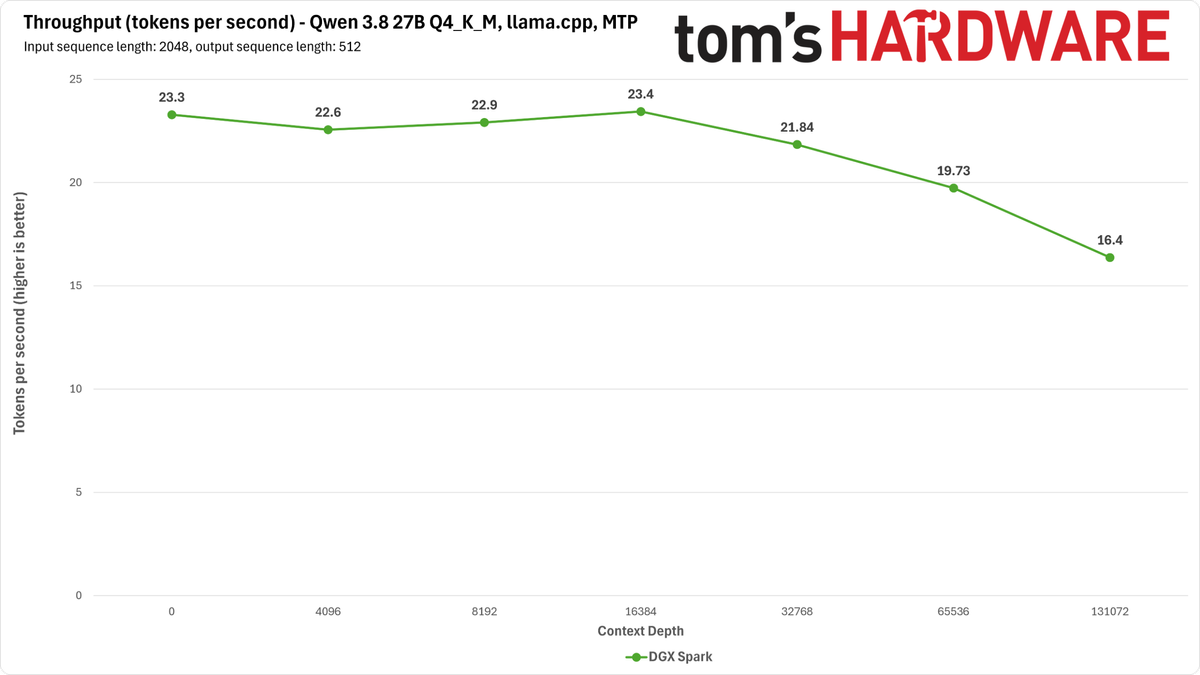
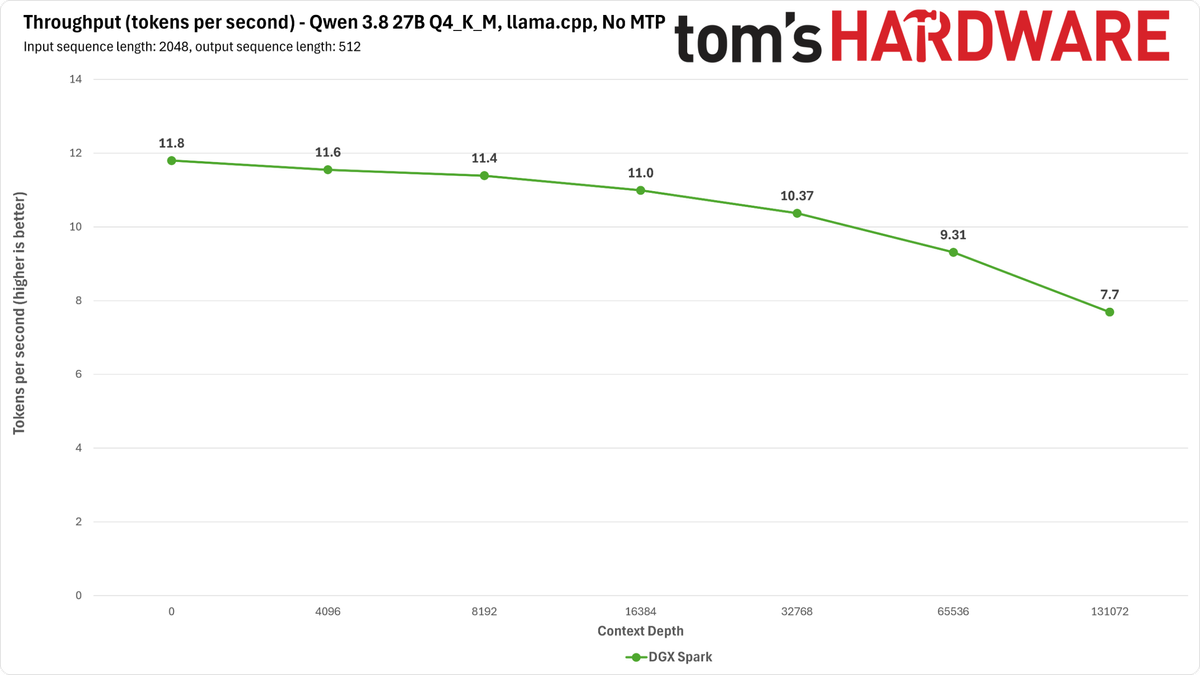
Заядлые энтузиасты локальных LLM могут скептически отнестись к пропускной способности памяти DGX Spark, составляющей всего 27 ГБ/с для такой плотной модели, как Qwen 3.8 27B, и наши предыдущие тесты подтверждают, что эта платформа не является самой быстрой для подобных задач. Но теперь, когда модели вроде Qwen 3.8 27B поддерживают MTP через простой флаг запуска сервера, можно получить значительный бесплатный прирост скорости декодирования на платформах с ограниченной пропускной способностью памяти. В наших тестах солидная производительность Spark при предварительной обработке (prefill) означает, что она зачастую завершает инференс на длинных контекстах быстрее, чем RTX 5090 с llama.cpp. Кроме того, Spark отлично поддерживается SGLang и vLLM. Учитывая, что стоимость одной системы Spark составляет около $5000 и она является готовым решением, которое в дальнейшем можно масштабировать в кластер, списывать её со счетов не стоит.
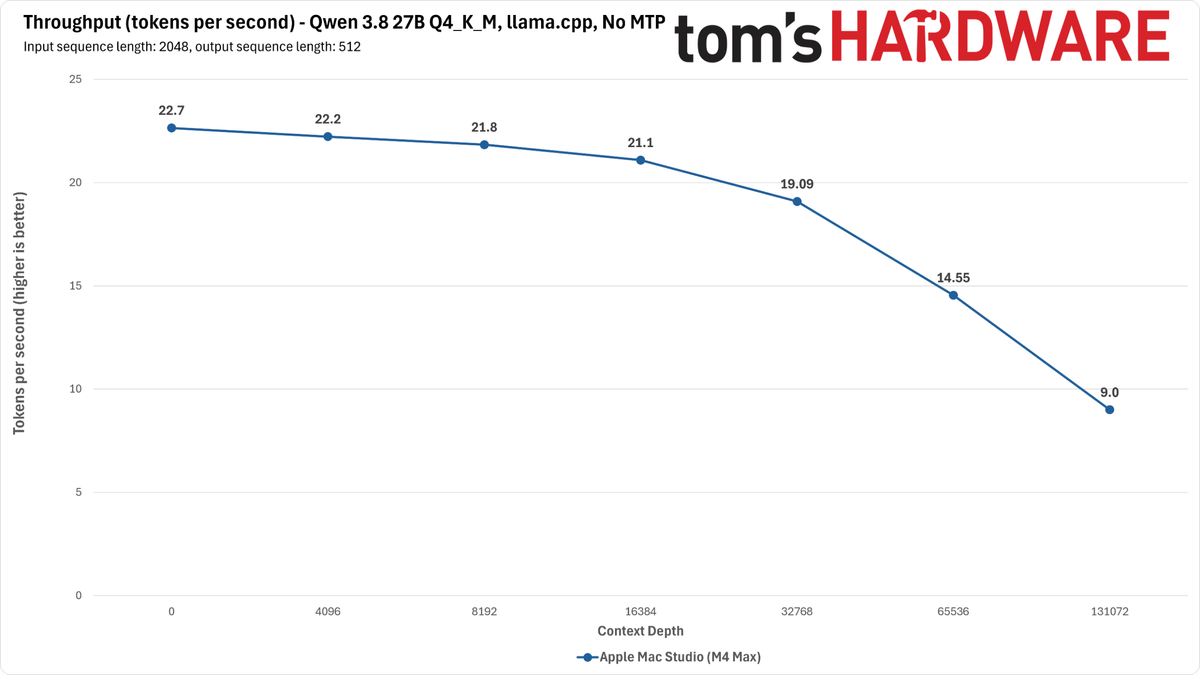
Что касается Mac Studio с чипом M4 Max, то он обладает самой высокой пропускной способностью памяти среди всех систем с объединенной памятью, имеющихся в наших лабораториях, но, как мы отмечали ранее, это лишь один из многих факторов, определяющих эффективность локального ИИ-инференса.
Особенности обработки промптов и производительность различных платформ
Обработка промптов на платформе Mac Studio происходит медленнее, чем на системе Spark. Несмотря на то что Mac Studio способен генерировать больше токенов в фазе декодирования, чем GB10, итоговое время одного цикла вывода (inference turn) при работе с длинными контекстами оказывается больше, чем у платформ Nvidia. Именно на длинных контекстах система тратит основную часть времени обработки.
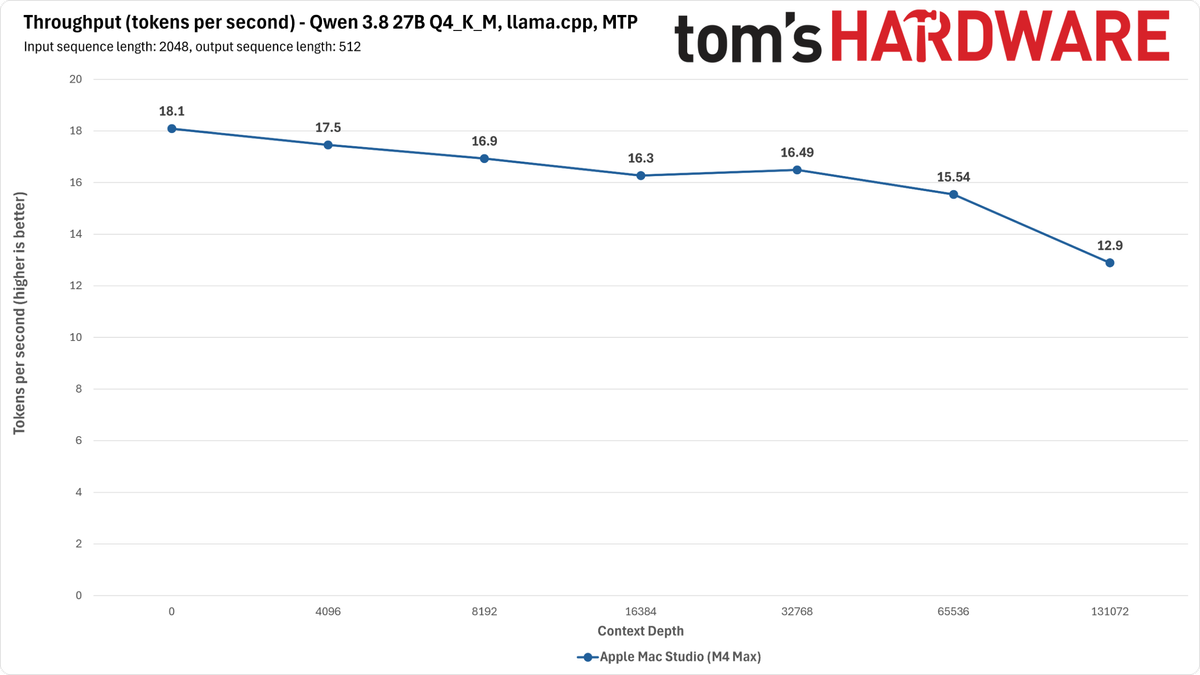
Более того, при использовании llama.cpp активация функции MTP на Mac Studio приводит к снижению производительности декодирования на коротких контекстах, предлагая лишь незначительное ускорение на длинных — в то время как на других платформах это обычно дает положительный эффект. Этот пример наглядно демонстрирует важность проведения реального тестирования вместо простого сравнения спецификаций.
Производительность Ryzen AI Halo (Strix Halo)
Процессор AMD Ryzen AI Halo демонстрирует наихудший сценарий для данной плотной модели: сочетание относительно низкой пропускной способности памяти и низкой скорости обработки промптов. Хотя активация MTP в llama.cpp позволяет немного увеличить количество токенов в секунду, это не компенсирует длительное время обработки промптов, необходимое для работы с большими контекстами. Запуск этой модели на базе Strix Halo возможен, однако для интерактивной работы с длинным контекстом стоит поискать более производительные решения.
Итоги тестирования и экономические реалии локального ИИ
Первоначальные ожидания, что тестирование производительности Qwen 3.8 27B сведется к простой установке видеокарты, загрузке модели и получению токенов, на практике обернулись необходимостью серьезной настройки. Многие системы, которые изначально казались непригодными для работы с подобной плотной моделью, оказались неожиданно полезными. В целом, заявления о сотнях токенов в секунду для «пустого» контекстного окна не учитывают весь спектр поведения большой языковой модели в реальных условиях.
Например, текущая реализация llama.cpp или особенности нашего программного стека приводят к тому, что ожидание ответа от Qwen 3.8 27B при длинном контексте на RTX 5090 может достигать 30 минут, что является неприемлемым результатом. При этом попытка сменить движок вывода на vLLM или SGLang ограничивает доступный контекст до 32 000 токенов на одной RTX 5090. Чтобы задействовать полные 262 000 токенов контекста, пришлось установить вторую RTX 5090; в такой конфигурации мы получили отличную пропускную способность и время до получения первого токена (TTFT), пригодное для интерактивной работы. Однако стоимость сборки подобной системы на данный момент превышает 13 000 долларов.
Стоит отметить, что DGX Spark с пропускной способностью памяти 273 ГБ/с показывает достаточно быструю предварительную обработку (prefill), что удерживает TTFT в интерактивном диапазоне, даже если скорость декодирования с MTP составляет около 20 токенов в секунду. В то же время, несмотря на высокую пропускную способность памяти у Mac Studio с чипом M4 Max, общее время вывода здесь ограничено скоростью обработки промптов старой архитектуры Apple Silicon. Чипы M5 Max и M5 Ultra, вероятно, показали бы лучшие результаты, но на момент тестирования они были недоступны.
Все это заставляет переосмыслить экономическую целесообразность локального ИИ. Затраты в 5 000, 10 000 или 15 000 долларов на «железо» эквивалентны огромному количеству токенов, которые можно было бы получить через современные модели Anthropic или OpenAI. Если время для пользователя является деньгами, то облачные решения предоставят результат быстрее, чем любая домашняя система, за исключением станций уровня DGX с GPU GB300. Поэтому, если у вас нет требований к работе с конфиденциальными данными на собственных мощностях, если вы не энтузиаст-экспериментатор и вас не беспокоит будущее дистрибуции открытых моделей, то нет необходимости в срочной сборке специализированной системы.
Тем не менее, если вы решите на это пойти, помните: реальная производительность зависит не только от объема VRAM или пропускной способности памяти. Популярные движки вроде llama.cpp могут не обеспечивать наилучший результат для вашей конфигурации. Тщательное экспериментирование и бенчмаркинг — единственный способ добиться максимальной эффективности.
Обозреватель графических решений
В должности старшего аналитика по графике в Tom’s Hardware Джефф Кампман занимается освещением всех тем, которые связаны с видеокартами, игровой производительностью и смежными вопросами.
Сфера его ответственности охватывает широкий спектр технологий: от встроенных графических процессоров и дискретных видеокарт до гипермасштабируемых вычислительных систем, обеспечивающих развитие технологий искусственного интеллекта. Если устройство оснащено графическим процессором, Джефф Кампман детально изучает его работу.
В ходе наших испытаний мы стремились охватить максимально широкий спектр оборудования, чтобы понять, какой именно программно-аппаратный стек необходим для раскрытия потенциала Qwen 3.8 27B. В дополнение к упомянутым решениям, наш список протестированного оборудования включал специфические устройства, такие как Radeon AI Pro R9700 и Arc Pro B70, которые также привлекли внимание сообщества своей архитектурой. Мы исходили из того, что для многих профессионалов важно не только «запустить» модель, но и обеспечить стабильный результат в задачах, где нетерпеливые агенты работают с данными, нивелируя границы человеческого восприятия.
Важным аспектом нашего исследования стала методология работы с движками. Там, где это было технически возможно, мы запускали тесты с включенными и отключенными функциями многотокенового предсказания (MTP). Стоит отметить, что далеко не все выбранные нами платформы могли поддерживать MTP в рамках доступного объема видеопамяти — этот нюанс мы детально отразили в аналитике по каждой системе и соответствующих графиках.
Нюансы работы с аппаратным обеспечением
Особого внимания заслуживает тот факт, что для работы на RTX 5090 с движком vLLM компания-разработчик предоставляет специфическую квантовку NVFP4 и готовые «рецепты» развертывания. Мы имели возможность испытать их в конфигурациях с одной и двумя картами RTX 5090. При использовании одной карты мы столкнулись с ограничением в 32К токенов контекста, что является критическим порогом для тех, кому требуется полное нативное окно модели в 262K. В таких случаях отсутствие достаточного объема VRAM делает невозможным включение MTP, что оставляет нас с базовой скоростью декодирования около 20 токенов в секунду.
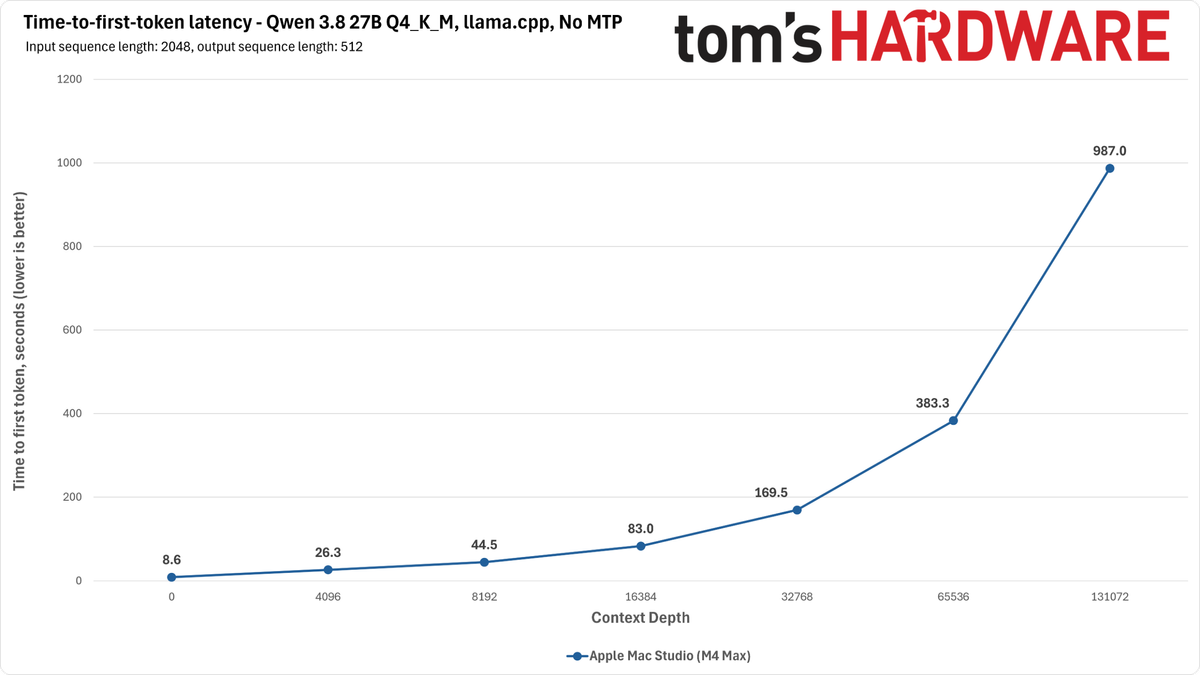
Что касается систем DGX Spark, то, несмотря на их кажущуюся «медлительность» по сравнению с топовыми видеокартами, они демонстрируют интересное поведение в бизнес-сценариях. Благодаря качественной оптимизации и поддержке MTP через серверный флаг, эти системы показывают предсказуемое время генерации первого токена (TTFT), что делает их надежным инструментом для долгосрочных задач, даже если абсолютная скорость генерации не бьет рекорды. Кроме того, возможность масштабирования Spark в полноценный кластер является весомым аргументом для тех, кто рассматривает локальный ИИ как инвестицию в инфраструктуру.
Особенности архитектур с унифицированной памятью
Анализ систем на базе Apple Silicon (в частности, Mac Studio с M4 Max) показал, что пропускная способность памяти — это лишь «одна из метрик». Наша практика показала, что использование MTP на данной платформе в среде llama.cpp может приводить к парадоксальному результату: производительность декодирования падает на коротких контекстах, и лишь при экстремально больших объемах данных начинает проявляться небольшой бонус. Это наглядно доказывает, что в индустрии локального ИИ «гонка спецификаций» (spec-racing) часто проигрывает реальным замерам производительности.
Худшим сценарием в наших тестах ожидаемо оказалась платформа Ryzen AI Halo (Strix Halo). Сочетание ограниченной пропускной способности памяти с низкой скоростью предварительной обработки (prefill) делает её не лучшим выбором для интерактивной работы с большими документами. Если пользователь планирует использовать модель для задач, требующих быстрого отклика от длинных контекстов, Strix Halo может стать «бутылочным горлышком» всей системы.
Выводы по программной совместимости
Наш опыт подчеркивает проблему «программного разрыва». Применение llama.cpp на текущем этапе развития может приводить к крайне нестабильным результатам, таким как 30-минутное ожидание ответа на RTX 5090, что прямо указывает на неоптимизированность стека для конкретных архитектур. В то же время, переход на vLLM или SGLang требует существенных жертв в виде значительного объема оперативной памяти (включая использование огромных файлов подкачки) и более консервативного подхода к размеру контекстного окна при работе на одной карте. Для достижения максимальной производительности пользователям приходится балансировать между аппаратными затратами, превышающими 13 000 долларов, и выбором правильного движка, который не будет «тормозить» возможности видеокарты.