Крупнейшие open source проекты продолжают вырабатывать стратегии взаимодействия с генеративным искусственным интеллектом. Если проект Debian официально разрешил использование ИИ в своих вкладах, а сообщество Rust приняло многоуровневую политику, ограничивающую его применение в коде, то Linux столкнулся с иного рода проблемой. В настоящий момент инфраструктура проекта испытывает серьезные трудности из-за агрессивных ИИ-скрейперов, которые бесконечно повторяют одни и те же запросы, потребляя колоссальный объем вычислительных ресурсов.
Критическое потребление вычислительных мощностей
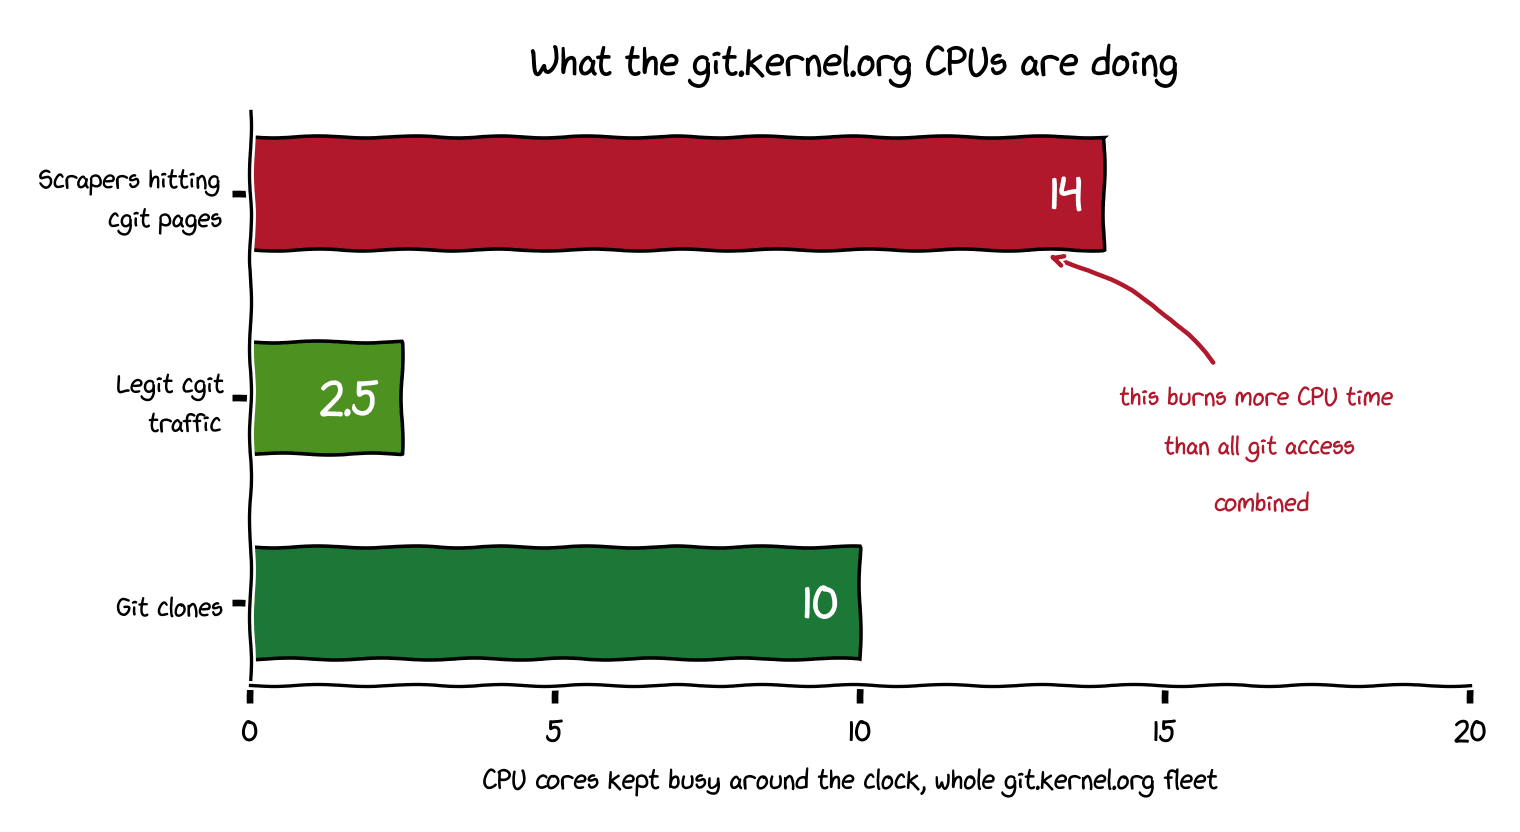
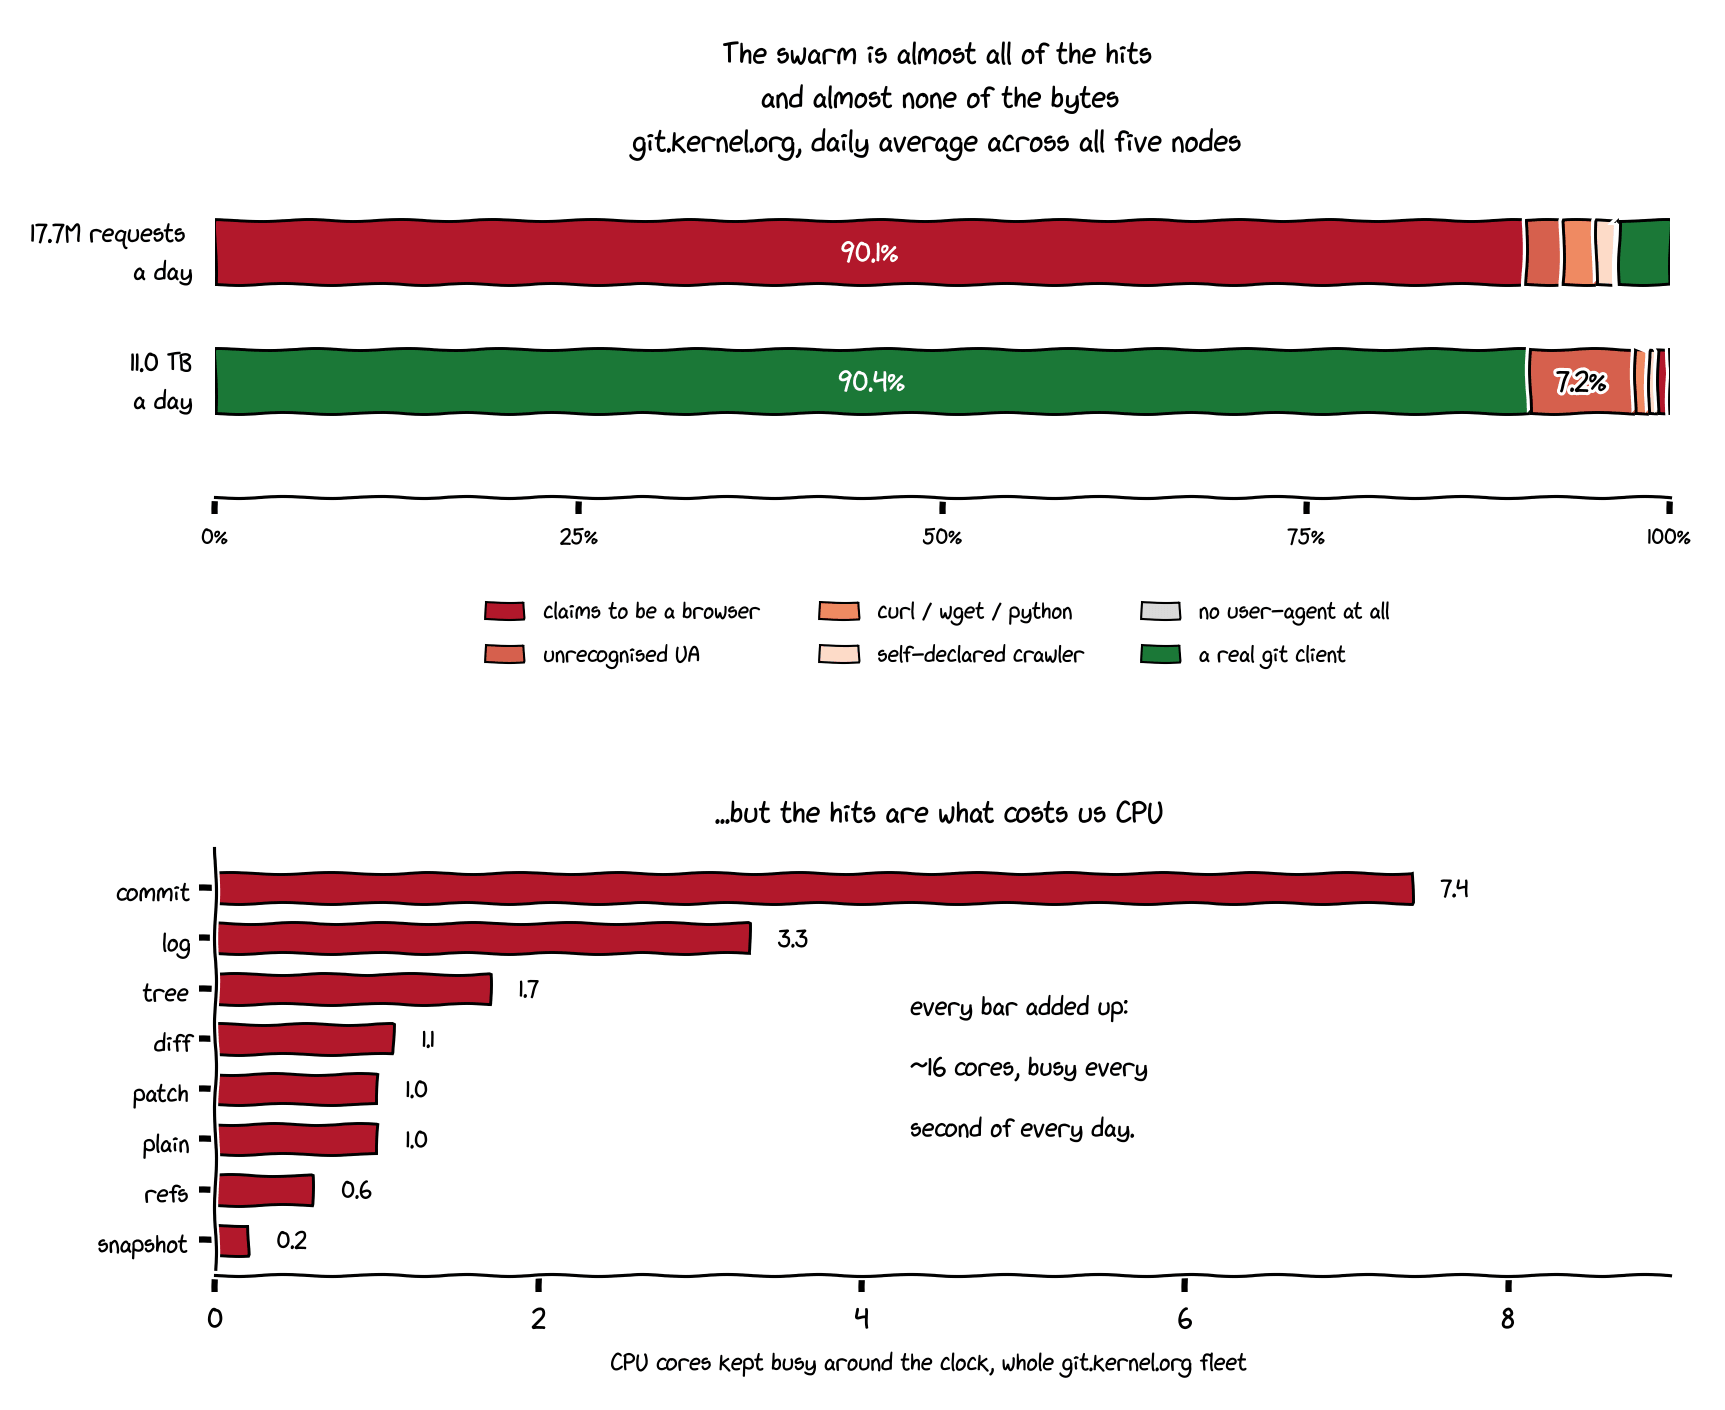
Константин Рябицев, директор по безопасности ИТ-инфраструктуры Linux Foundation и системный администратор kernel.org, представил данные о нагрузке на серверы. По его словам, около 14 из 90 процессорных ядер, распределенных по пяти узлам git.kernel.org, круглосуточно заняты исключительно преобразованием коммитов в HTML-страницы. Несмотря на то что история ядра Linux находится в открытом доступе и доступна для клонирования, ИИ-боты продолжают использовать крайне неэффективные методы сбора данных.
Согласно расчетам Рябицева, обычное локальное клонирование репозитория linux.git требует около 200 секунд серверного времени. В то же время попытка собрать те же 1,48 миллиона коммитов через отдельные страницы cgit расходует до 280 часов процессорного времени. Учитывая наличие 922 форков на сервере, общая стоимость такого парсинга достигает 258 160 часов работы процессоров, что в 4,6 миллиона раз дороже, чем стандартное клонирование всего архива целиком.
Противостояние ботам и поиск решений
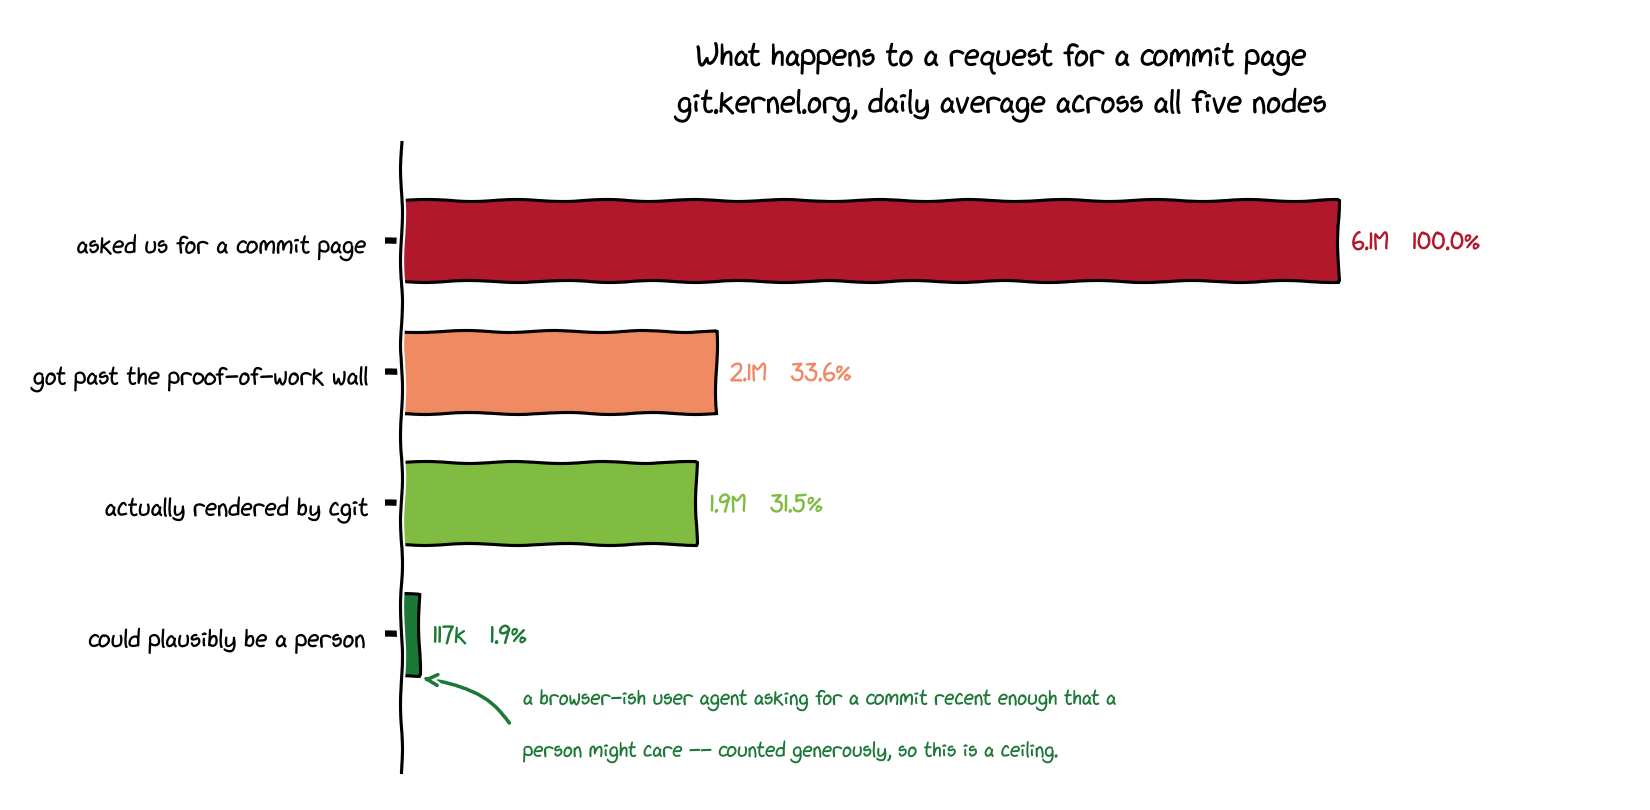
Ситуация осложняется тем, что cgit генерирует отдельные URL для каждого патча, diff-файла и текстового представления коммита, что увеличивает количество индексируемых страниц до квадриллионов. Попытки администраторов заблокировать вредоносные действия превратились в своего рода гонку вооружений:
- Применение Fail2Ban и блокировок по IP-адресам работало лишь до тех пор, пока боты не начали распределяться по целым подсетям.
- Блокировки по ASN также оказались неэффективными, так как ИИ-инструменты стали использовать миллионы домашних и мобильных IP-адресов.
- Внедрение системы Anubis, требовавшей решения вычислительной задачи (proof-of-work) для доступа к контенту, работало некоторое время, но боты адаптировались, научившись обходить фильтры возрастающей сложности.
На данный момент, как отмечает Рябицев, до 20% всех мощностей серверов уходит на обслуживание скрейперов, причем нагрузка распределяется неравномерно и часто обрушивается на проект мощными «волнами». Специалист надеется, что после завершения «пузыря ИИ» количество подобных сущностей сократится, либо их разработчики начнут использовать более рациональные методы извлечения данных.
Проблема нерационального использования ресурсов в индустрии
Проблема избыточного расхода вычислительных ресурсов не является уникальной для git.kernel.org, хотя на примере репозитория ядра она прослеживается наиболее отчетливо. Масштабирование моделей искусственного интеллекта требует колоссальных затрат энергии и мощностей на задачи, которые могли бы выполняться значительно быстрее и эффективнее. На текущий момент разработчики подобных систем не проявляют видимой обеспокоенности из-за нерационального потребления ресурсов, продолжая наращивать объемы сбора данных любой ценой.
Почему репозиторий Linux стал целью №1
Важно понимать, почему именно проект Linux стал объектом такого пристального внимания со стороны создателей ИИ. Репозиторий проекта представляет собой «золотую жилу» обучающих данных. В нем хранится не просто основной код ядра, но и все стабильные ветки релизов за многие годы, десятки деревьев сопровождения подсистем и даже исторические архивы, предшествовавшие появлению Git, включая эпоху BitKeeper. Для разработчиков нейросетей этот массив информации является эталонным стандартом того, как должен выглядеть качественный программный код.
Однако методы, которые выбирают «кланкеры» (так Рябицев иронично называет автоматизированные системы сбора данных), выглядят абсурдными. Вместо того чтобы один раз скачать весь репозиторий, что является стандартной практикой для любого разработчика, боты пытаются «выкачать» его через веб-интерфейс, запрашивая каждую страницу по отдельности. Это порождает колоссальную избыточность: те же самые данные, которые бесплатно и легально доступны для клонирования, тратят миллионы часов процессорного времени на бессмысленную генерацию HTML-кода.
Экономика жадности в эпоху ИИ
Ситуация с git.kernel.org — это лишь самый наглядный пример общей проблемы в индустрии разработки искусственного интеллекта. Масштабирование моделей требует бесконечного потребления данных, и разработчики ИИ подходят к этому процессу с философией «всего и побольше», не задумываясь об эффективности и нагрузке на инфраструктуру тех, у кого эти данные заимствуются. Константин Рябицев отмечает, что текущий подход разработчиков ИИ сродни ненасытности — они не заботятся о том, какой ценой достаются им байты данных, пока ресурсы кажутся безграничными.
Тем не менее, история учит, что подобная стратегия экстенсивного роста рано или поздно упирается в экономические реалии. Когда «пузырь ИИ» начнет сдуваться, многие компании неизбежно столкнутся с тем, что нерациональное расходование ресурсов перестанет окупаться. Рябицев надеется на то, что в будущем создатели моделей «поумнеют» и перейдут на использование более разумных методов доступа к публичным архивам кода, перестав превращать серверы критически важной инфраструктуры в полигон для своих неэффективных алгоритмов.
На данный момент проект продолжает нести потери, а нагрузка на серверы остается крайне нестабильной. Хотя в среднем 14–16 ядер из 90 заняты обработкой запросов от ботов, периодически случаются резкие всплески активности, когда «рои» скрейперов обрушиваются на систему одновременно. Это не только создает технические сложности, но и ставит под угрозу доступность ресурсов для реальных разработчиков, которые ежедневно работают над развитием ядра Linux.