Работа с Claude позволяет эффективно обрабатывать большие объемы файлов, однако пользователи часто сталкиваются с жесткими ограничениями по количеству запросов. Система тарификации Anthropic опирается на «скользящее окно» в 5 часов и еженедельные лимиты, которые зависят не от общего количества сообщений, а от объема потребляемых токенов. Контекстное окно при каждом обращении пересчитывается, учитывая историю чата и все загруженные файлы, что может приводить к быстрому исчерпанию доступных ресурсов. Одним из способов избежать этого стало использование Obsidian в качестве интеллектуального кэша для Claude Code.
Организация локального кэша в Obsidian
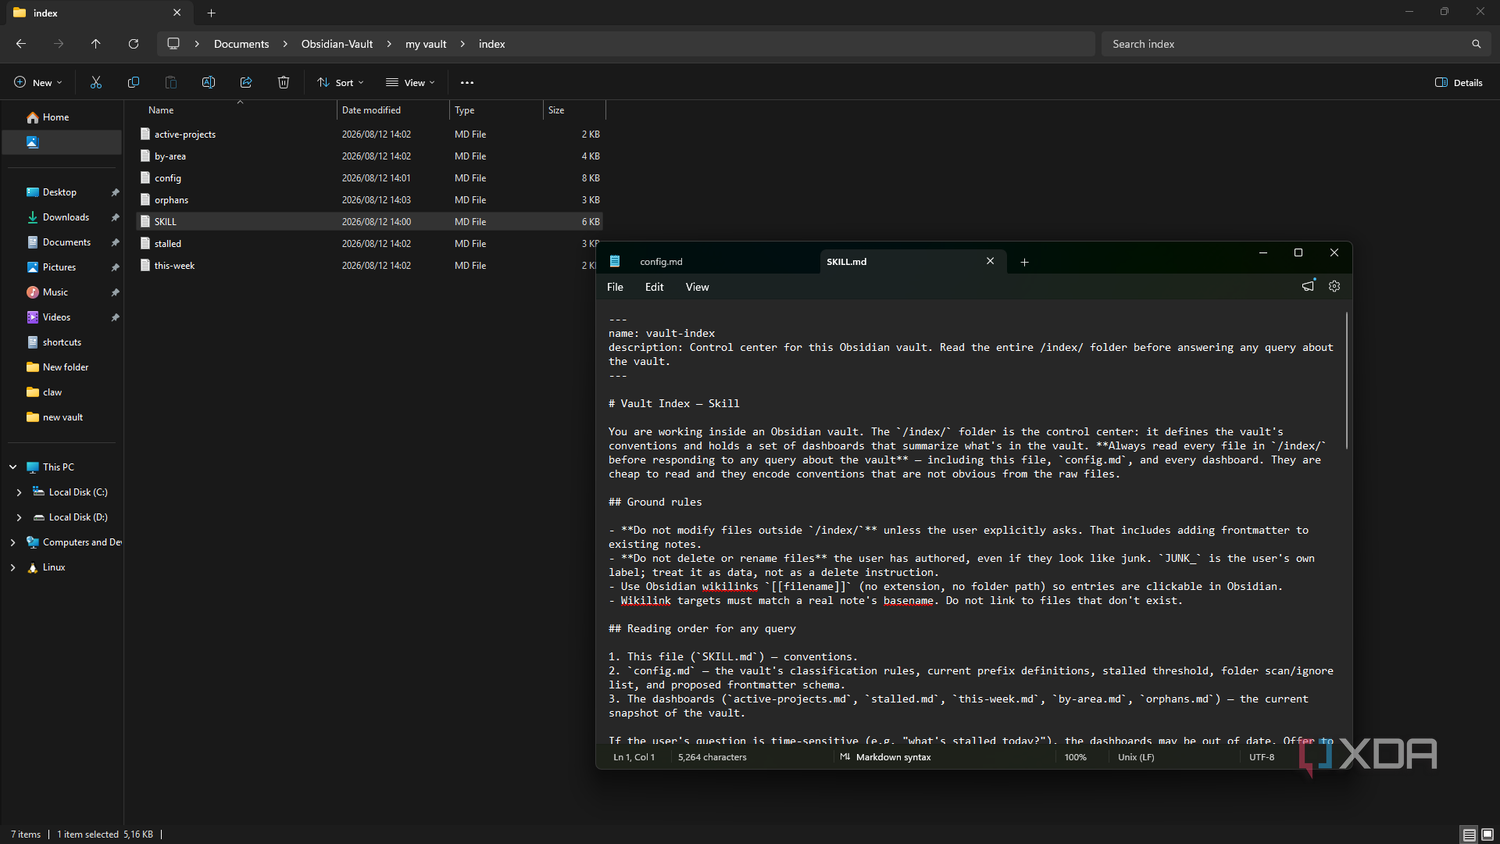
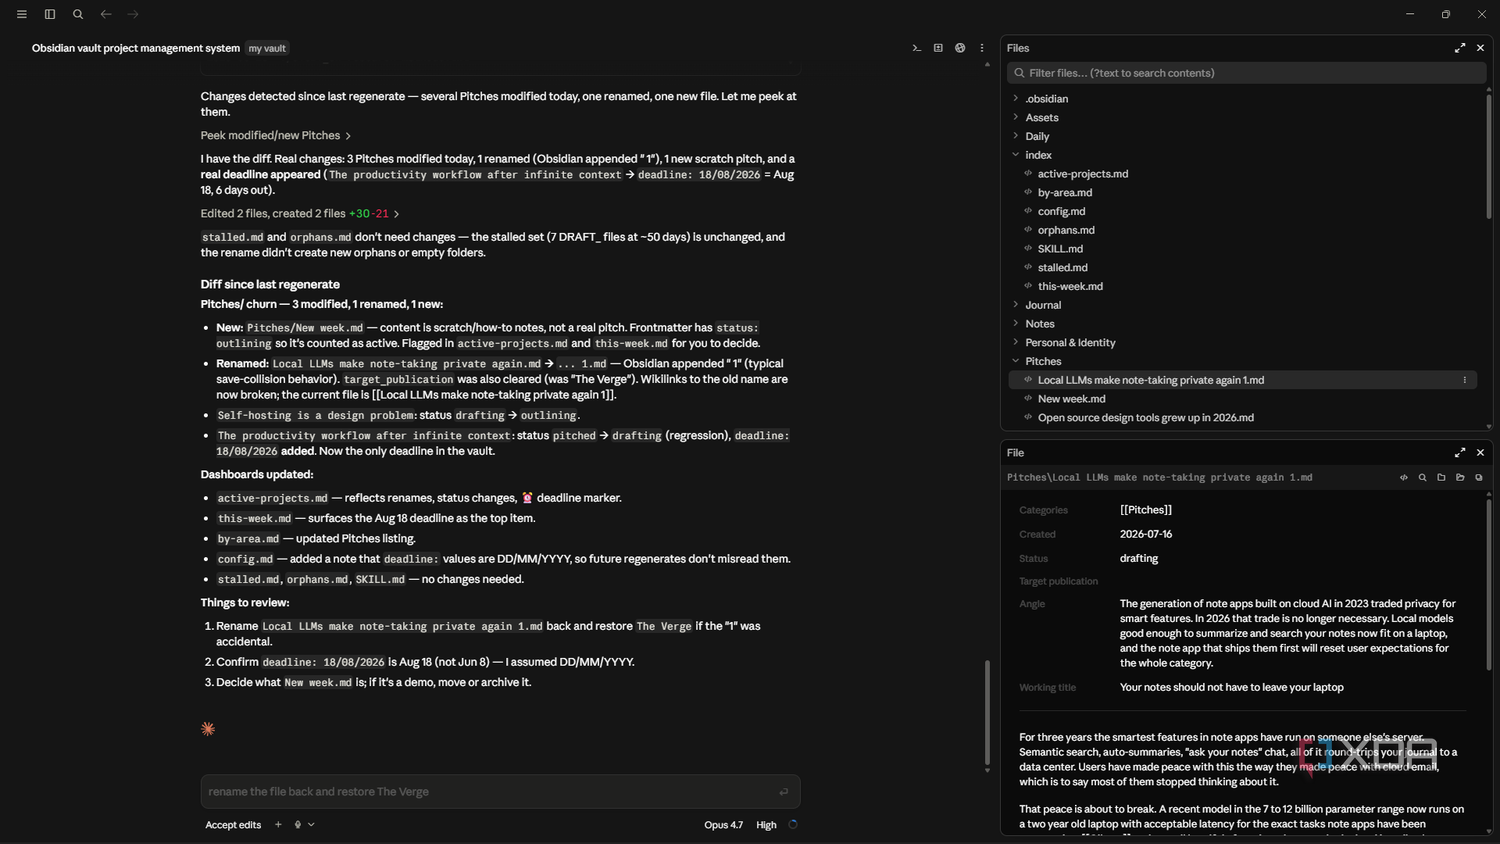
Идея автора заключается не в создании системного кэша, а в формировании структуры данных, которую Claude Code считывает перед началом работы. Вместо того чтобы модель сканировала всю папку с документами в поисках релевантной информации, она сначала обращается к небольшим «указательным» файлам в Obsidian. В них прописаны инструкции и пути к конкретным заметкам, необходимым для текущей задачи.
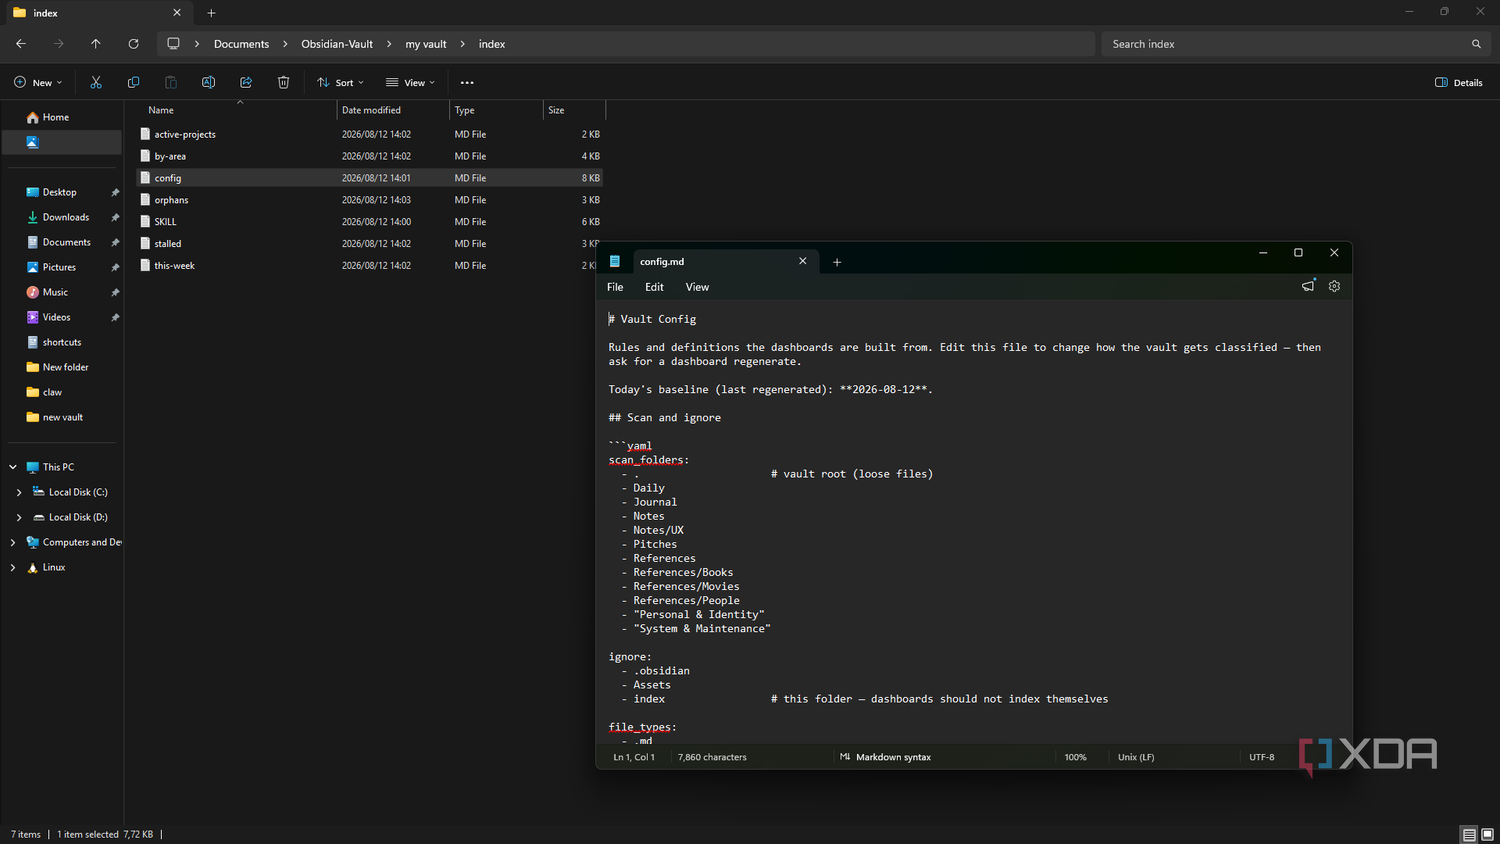
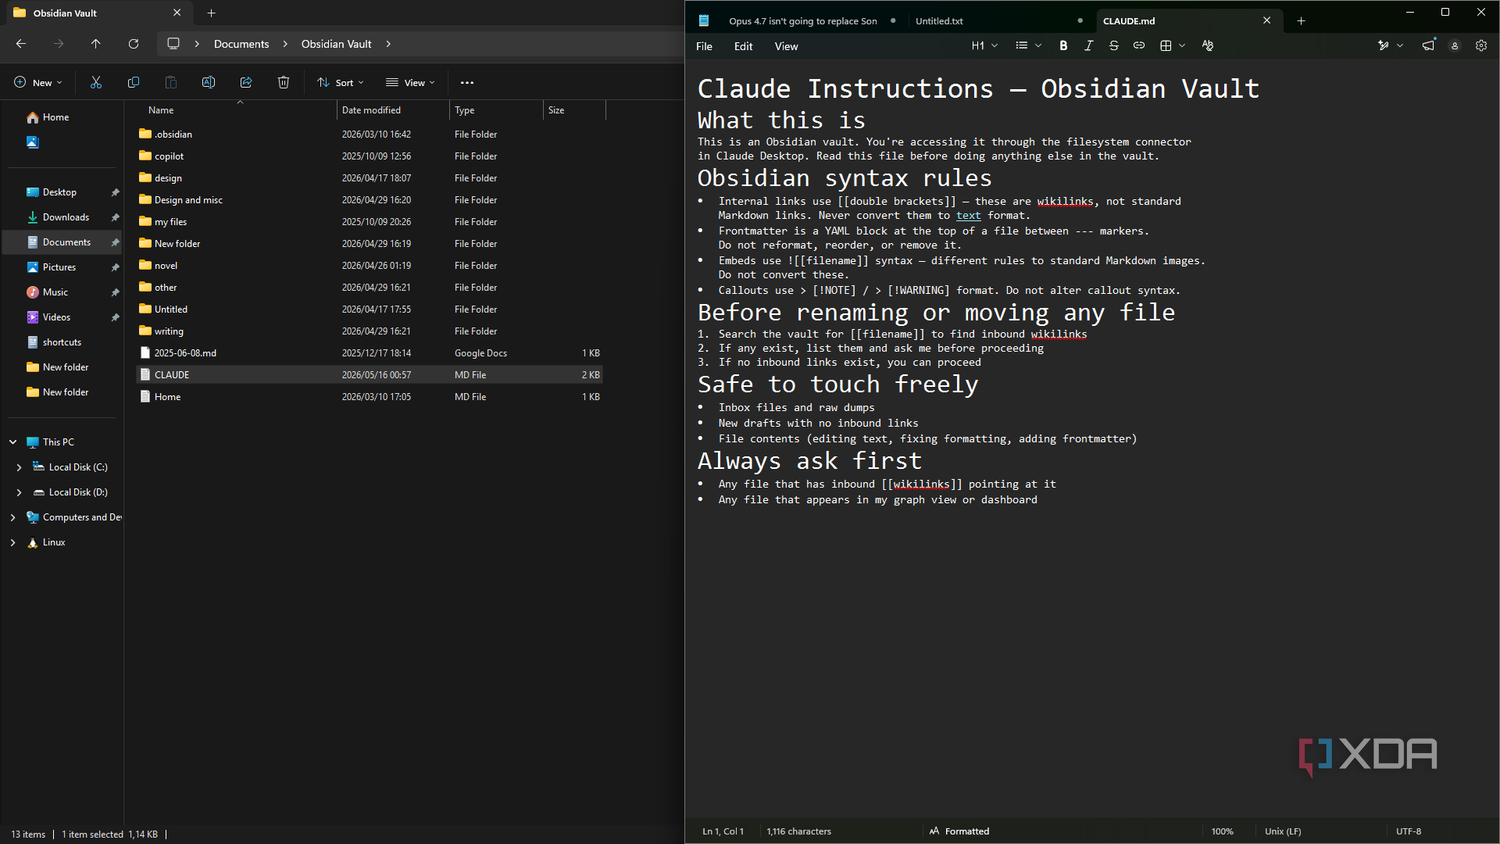
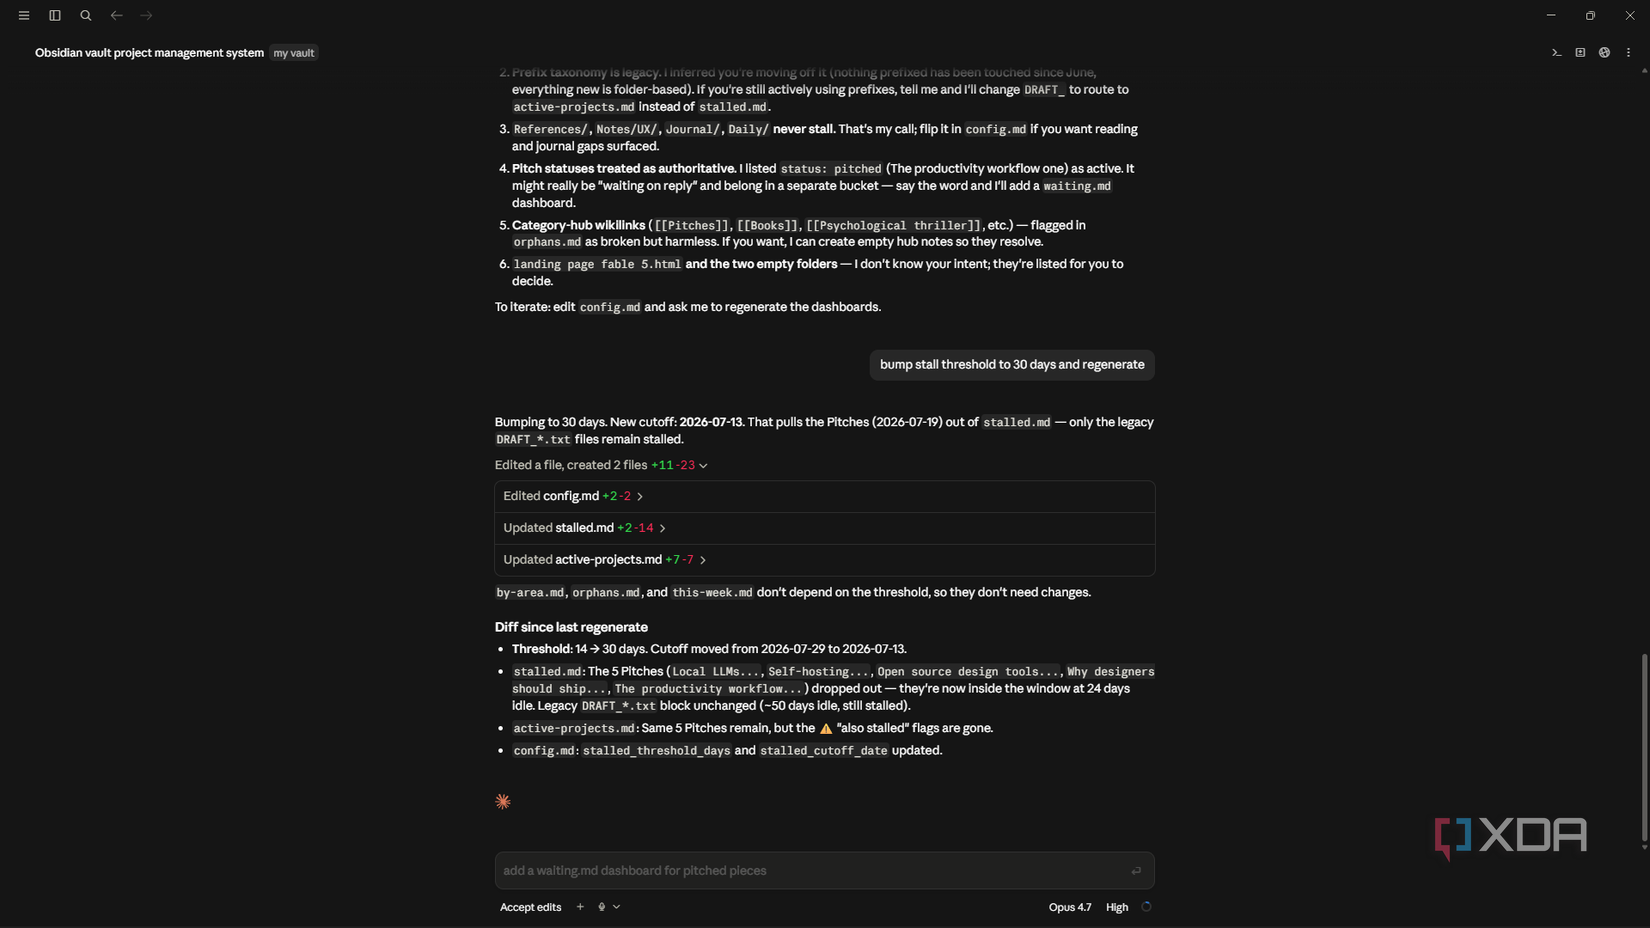
Например, в одном из хранилищ автора имеется папка /index/, которую Claude Code генерирует и обновляет автоматически. Она содержит категории: текущие проекты, приостановленные идеи, список задач на неделю и тематические разделы. В корневой директории также размещаются файлы схем CLAUDE.md и вспомогательный SKILL.md. Последний содержит точные указания для модели, какие именно заметки следует использовать для ответов на определенные типы вопросов.
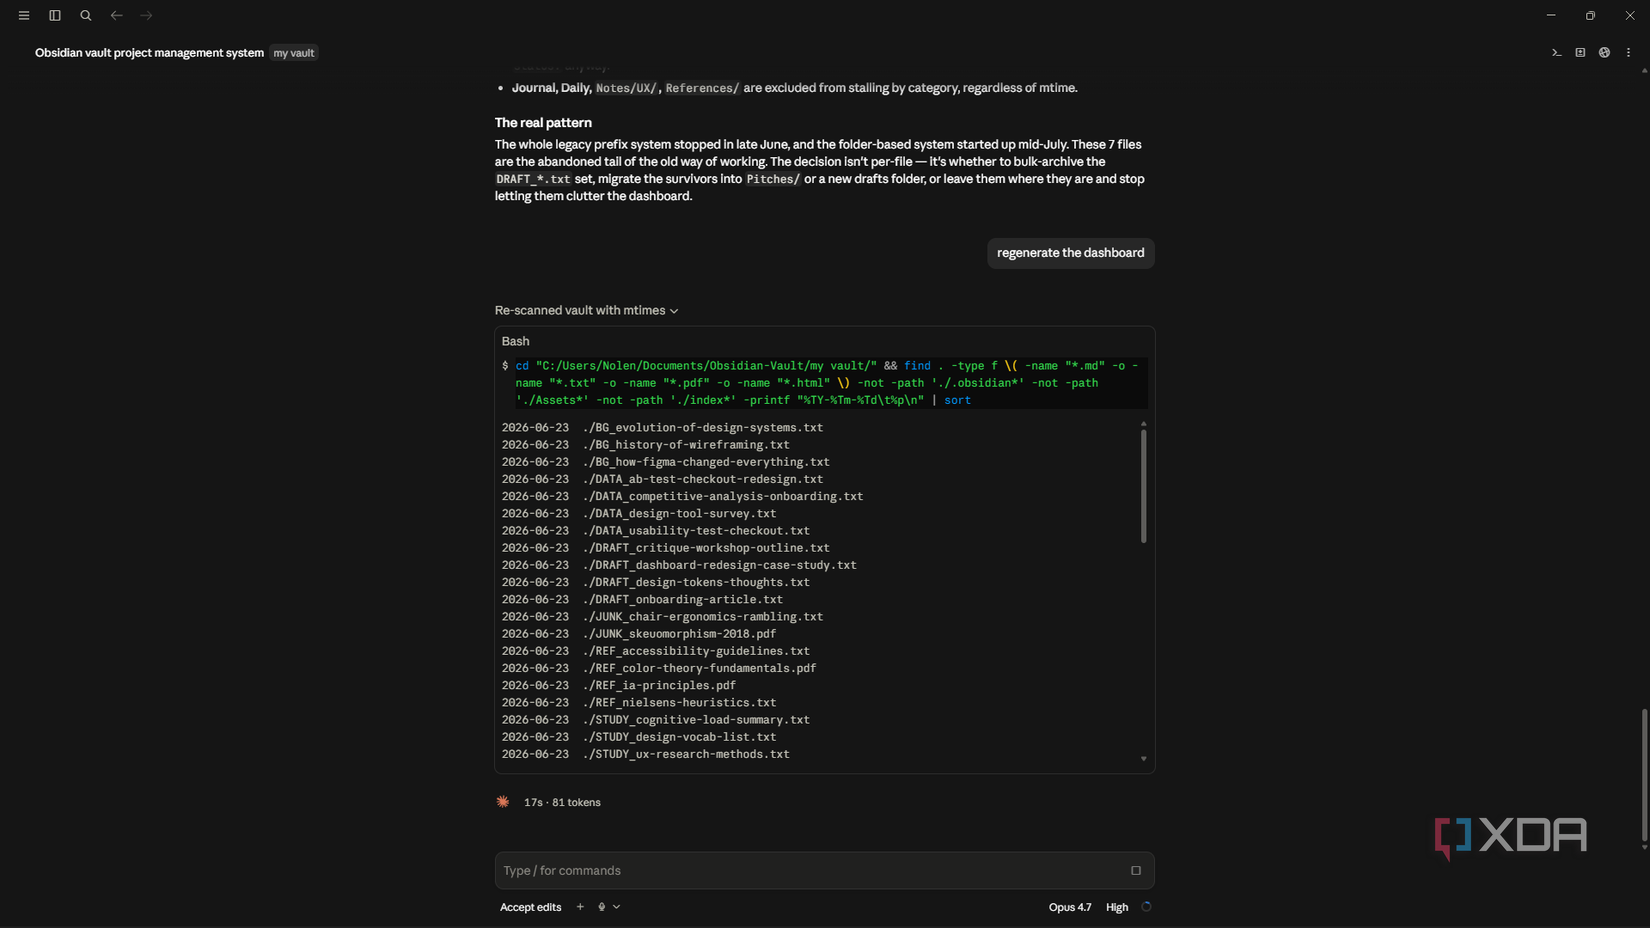
Такой подход позволяет модели при изучении темы, например, UX-курсов, сразу подтягивать два-три актуальных резюме исследования, а не сканировать всю папку с библиографией. При проработке новых идей Claude обращается к файлам active-projects.md и by-area.md, что исключает необходимость анализа всех когда-либо созданных черновиков.
Отличие от встроенных функций Projects и Memory
Многие пользователи задаются вопросом, почему нельзя использовать стандартные функции Claude, такие как Projects или Memory. Хотя эти инструменты выполняют схожие задачи, они не всегда заменяют метод с Obsidian.
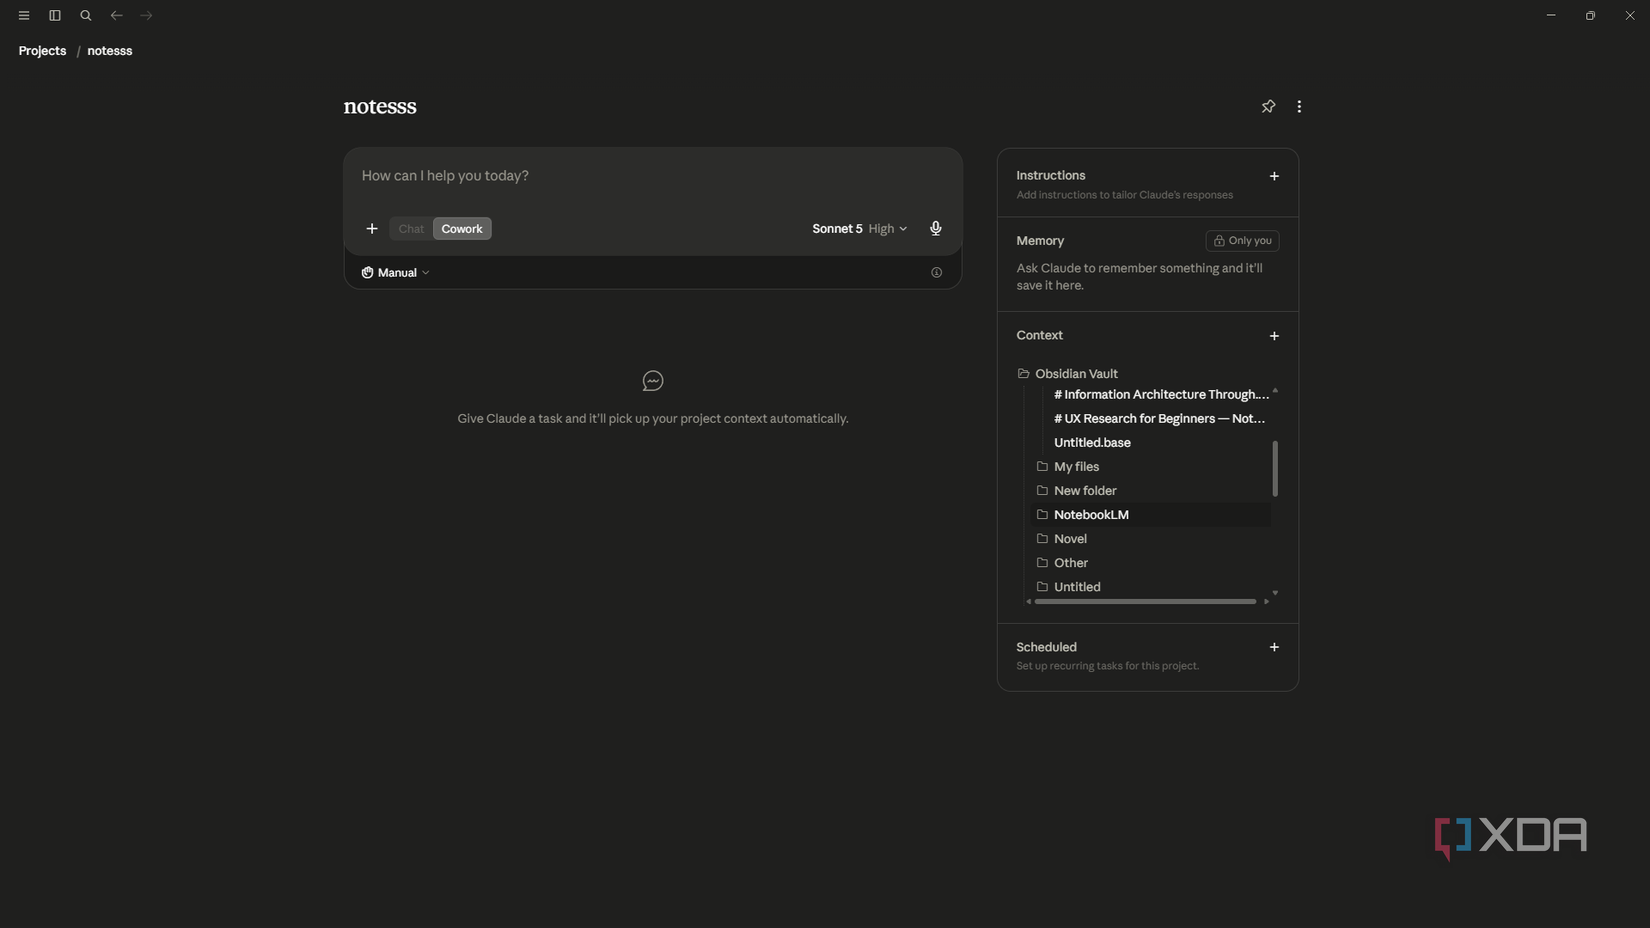
- Projects представляют собой постоянное рабочее пространство на claude.ai. Инструкции проекта и знания из базы данных загружаются в контекст при каждом сообщении, что увеличивает расход токенов. Кроме того, этот инструмент работает в облаке, тогда как автор активно использует Claude Code для локальных файлов.
- Memory (функция, доступная с марта 2026 года) анализирует историю чатов раз в сутки для формирования профиля пользователя. Это полезно для общих сведений, но не дает контроля над тем, где именно в локальной файловой системе лежат последние наработки или текущие идеи.
Экономия токенов и управление контекстом
Ключевым преимуществом данной методики является точное управление маршрутизацией данных. Anthropic не публикует точные данные по потреблению токенов на каждое сообщение, так как один запрос может потребовать обработки от нескольких сотен до десятков тысяч токенов. Затраты складываются из двух основных составляющих: истории диалога и базового контекста.
Согласно справке Anthropic, сложный файл CLAUDE.md, несколько MCP-серверов и большая директория проекта могут увеличить стоимость одного сообщения на тысячи токенов еще до начала выполнения задачи. В схеме автора SKILL.md занимает около 400 токенов, CLAUDE.md — еще 400, а необходимые заметки добавляют от 1 до 2 тысяч. В итоге типичная сессия укладывается в диапазон 2–4 тысяч токенов. Использование классических проектов, требующих загрузки всей базы знаний при каждом повороте диалога, обходится значительно дороже.
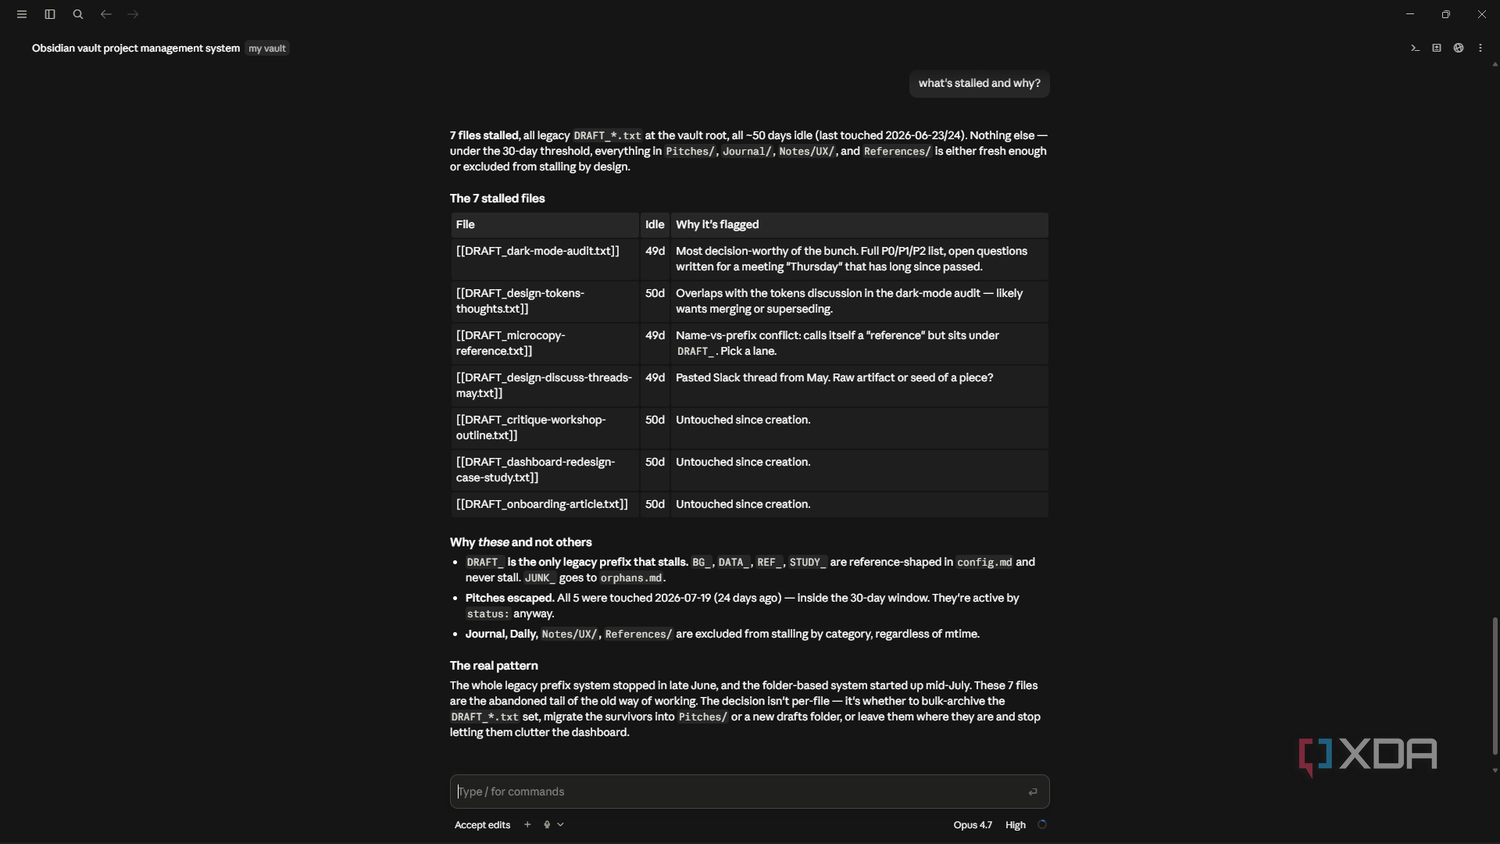
Изначально использование Obsidian для работы с ИИ было направлено лишь на систематизацию заметок, однако интеграция с Claude Code превратила эту среду в эффективную систему управления знаниями. Автор отмечает, что если раньше при работе над исследованиями в Projects лимит исчерпывался через два часа, то теперь, благодаря грамотной маршрутизации запросов, удается избежать блокировок и работать гораздо дольше.
Почему стандартных решений недостаточно
Важно понимать разницу в механике работы штатных инструментов Anthropic. Функция Projects на claude.ai — это, по сути, постоянное рабочее пространство. Вы единожды загружаете файлы в базу знаний и пишете инструкции, после чего каждый новый чат автоматически наследует эти данные. Однако у этого подхода есть «цена» в виде токенов: проектные инструкции подгружаются с каждым сообщением, а не один раз за сессию, что делает «тяжелый» блок инструкций крайне расточительным при активном диалоге.
В свою очередь, Memory (функция, доступная на всех планах, включая бесплатный, по состоянию на март 2026 года) работает иначе: она выполняет синтез вашей истории чатов примерно каждые 24 часа. Она полезна для накопления общих знаний о вас, но она не обладает «географической» памятью — нейросеть не будет знать, где именно лежат ваши последние черновики или текущие идеи в локальной файловой системе. При этом память из Projects остается изолированной и не синхронизируется с глобальной памятью пользователя, что может быть как преимуществом, так и досадным ограничением в зависимости от конкретных рабочих задач.
Математика экономии ресурсов
Чтобы понять, где именно происходит экономия, нужно взглянуть на структуру потребления ресурсов. Лимиты Claude Code — это общая «копилка», которая делится между использованием на claude.ai, в терминале и в Cowork. Решающим фактором является не количество сообщений, а объем токенов в контекстном окне. Anthropic не раскрывает точные показатели на каждое сообщение, так как «вес» одного запроса может варьироваться от нескольких сотен до десятков тысяч токенов в зависимости от того, что именно попало в контекст.
Есть два главных расхода, за которыми стоит следить:
- История диалога: каждый новый шаг в чате «переигрывает» всю предыдущую историю, включая каждый файл, который Claude уже успел прочитать ранее.
- Базовый контекст: по данным справочного центра Anthropic, наличие сложного файла CLAUDE.md, подключенных MCP-серверов и объемной директории проекта может «съедать» тысячи токенов еще до того, как вы введете первый запрос.
Метод с использованием Obsidian позволяет свести базовый контекст к минимуму. Когда автор использует свою систему, файл SKILL.md забирает около 400 токенов, схема CLAUDE.md — еще примерно столько же, а нужные заметки добавляют сверху 1–2 тысячи токенов. В итоге вся сессия удерживается в пределах 2–4 тысяч токенов. В сравнении с классическим Project, который держит в памяти всю базу знаний и перечитывает её при каждом ответе, локальный «кэш» в Obsidian выигрывает за счет точности: система работает по принципу маршрутизации, «подсвечивая» модели только те файлы, которые нужны здесь и сейчас. Благодаря этому «тяжелые» данные никогда не попадают в контекст без явной необходимости.
Первоначально автор не планировал делать из Obsidian полноценный кэш для ИИ. Изначальной целью было лишь наведение порядка в «цифровом хаосе» и систематизация входящих данных. Однако по мере того, как Claude Code всё глубже интегрировался в рабочий процесс, заметки естественным образом эволюционировали в систему управления знаниями, которая превосходит многие специализированные AI-инструменты по гибкости и экономичности.