Развертывание системы мониторинга вне основного сервера
Изначально я установил дашборд Homarr на свой хоумлэб-сервер для контроля за состоянием системы. Однако по классике жанра: я настроил дашборд, полюбовался им и перестал в него заглядывать. Это создало очевидную проблему: страница статуса не может предупредить о неполадках, если сама бездействует на том же сервере, который должна мониторить. Кроме того, я отстал от трендов в области визуальных инструментов автоматизации, так как привык писать скрипты, а не выстраивать визуальные рабочие процессы. Сравнив Make и n8n, я выбрал n8n, поскольку это программное обеспечение с fair-code лицензией можно запустить на собственном железе.
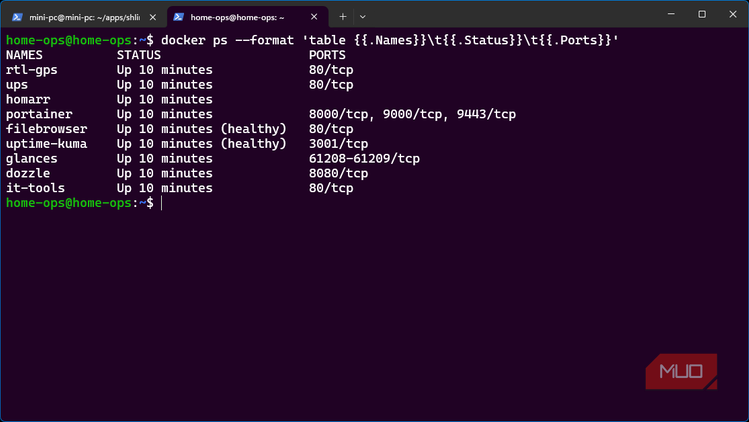
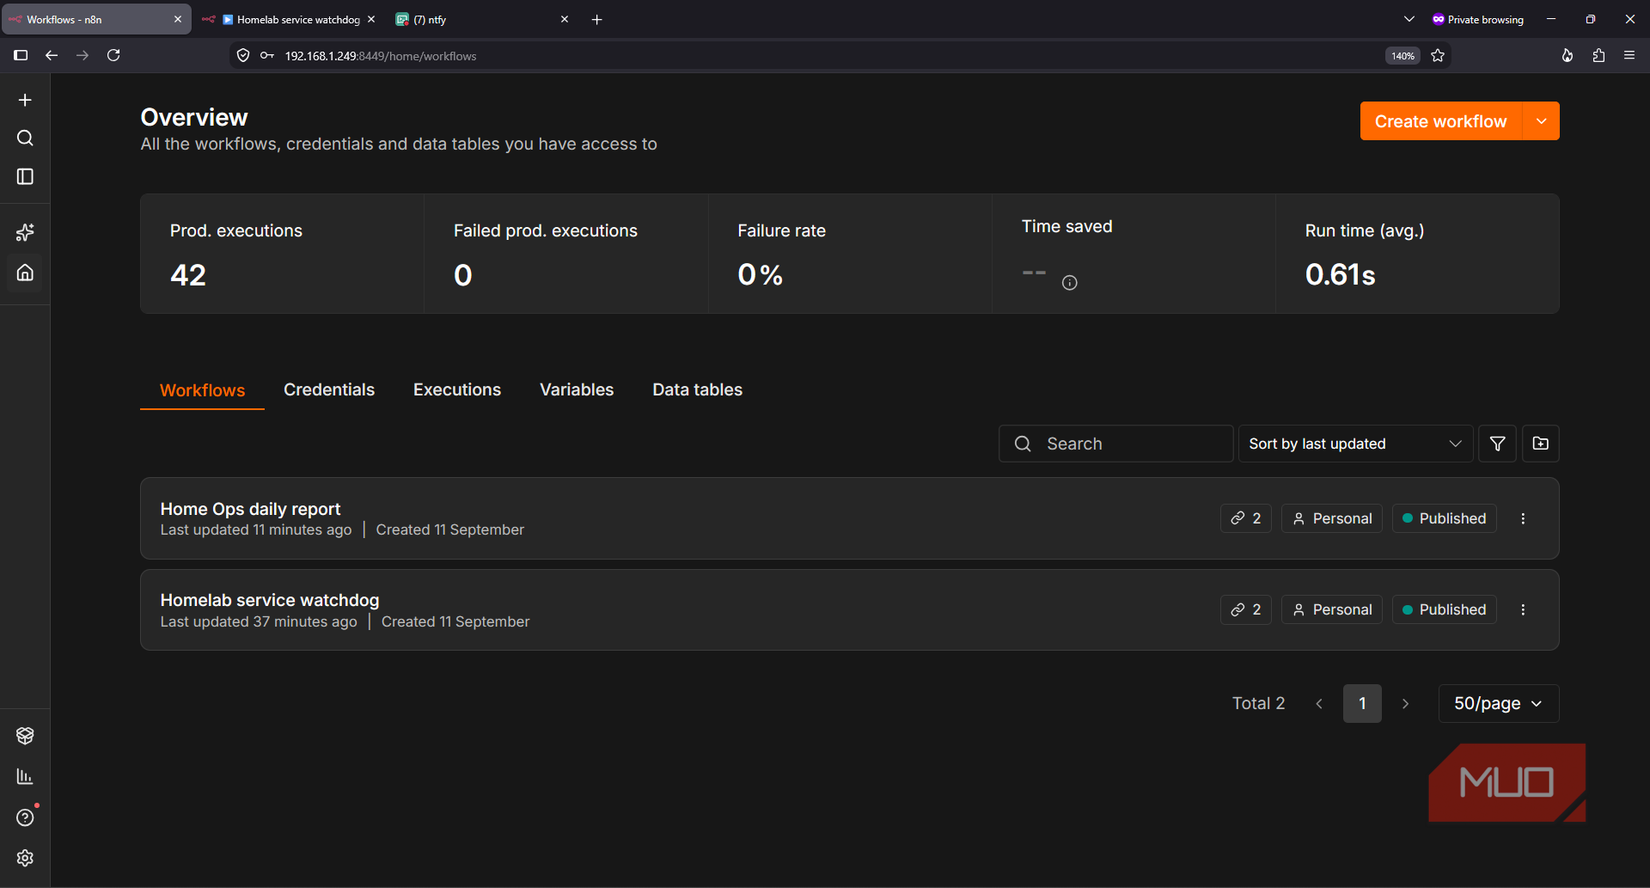
Я установил n8n на отдельный мини-ПК, чтобы он проверял шесть сервисов, выполнял повторные попытки при сбоях, отправлял уведомления в Telegram и формировал ежедневный отчет о состоянии системы. Сторожевой таймер должен находиться вне сервера, который он отслеживает, чтобы пережить потенциальные сбои. Мой сервер Home Ops стал идеальной целью для тестирования мониторинга. Это виртуальная машина Ubuntu с доступом к локальной сети через адаптер с IP-адресом 192.168.1.153. В настоящее время на ней запущены девять контейнеров: Homarr, Uptime Kuma, Portainer, Glances, File Browser, Dozzle, IT-Tools, мониторинг батареи ИБП и коннектор для радиолюбительского проекта.
Я не хотел размещать «сторожа» на той же виртуальной машине: если бы она зависла или упал стек Docker, уведомление об аварии просто не сработало бы. Поэтому я установил n8n вместе с ntfy на отдельный мини-ПК (IP 192.168.1.249), который уже работал независимо от Home Ops. Для n8n я зафиксировал версию 2.38.6 вместо использования latest и примонтировал директорию данных к хосту, чтобы воркфлоу и учетные данные сохранялись при пересоздании контейнера:
services:
n8n:
image: docker.n8n.io/n8nio/n8n:2.38.6
restart: unless-stopped
ports:
— «127.0.0.1:5678:5678»
volumes:
— ./data:/home/node/.n8n
Порт 5678 я привязал к localhost, чтобы не открывать его напрямую в локальную сеть. Caddy взял на себя все внешние соединения, обслуживая n8n через внутренний HTTPS на порту 8449. Монитор стал изолированным, постоянным и доступным.
Автоматизация проверок с анализом состояний
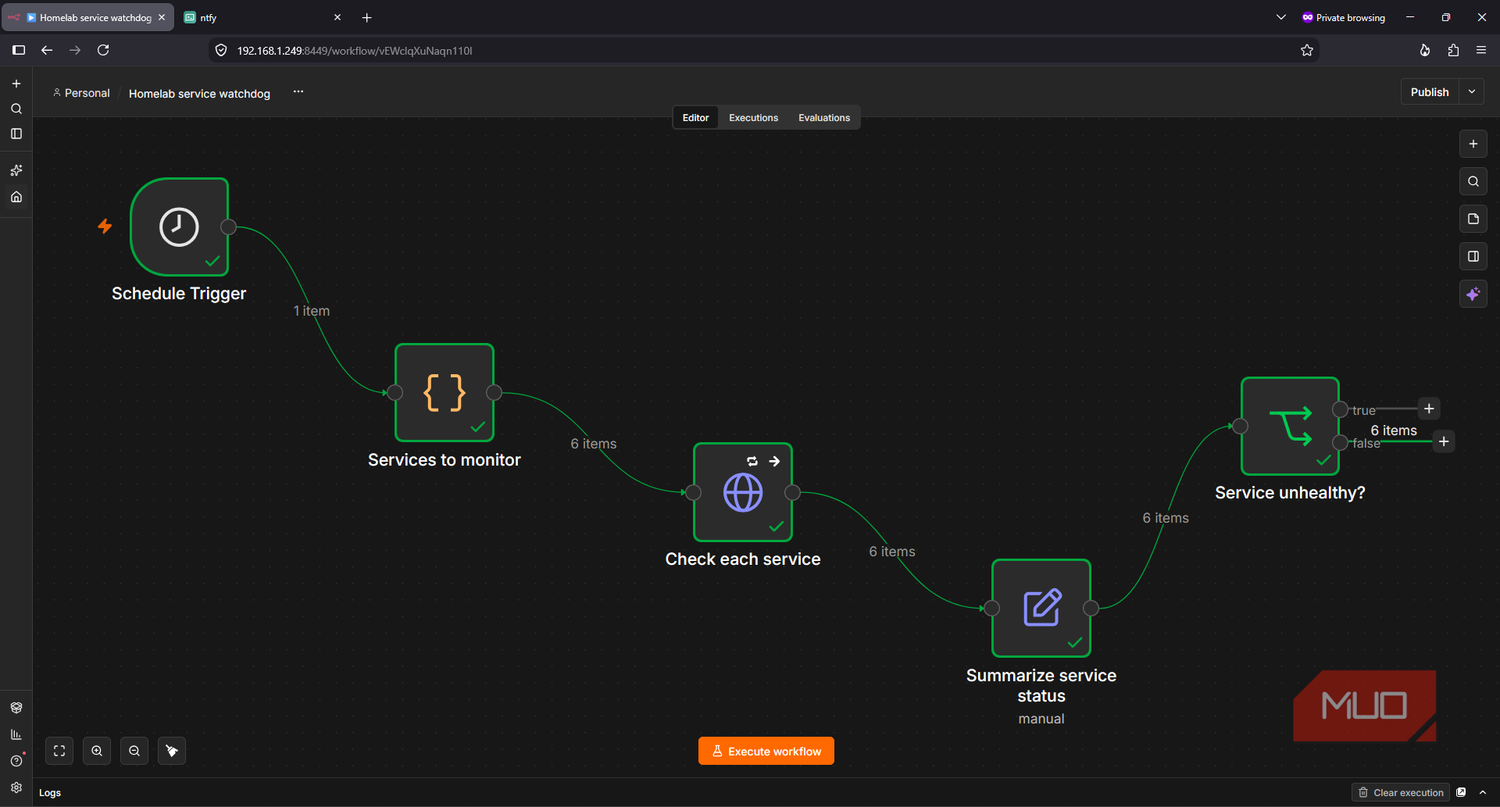
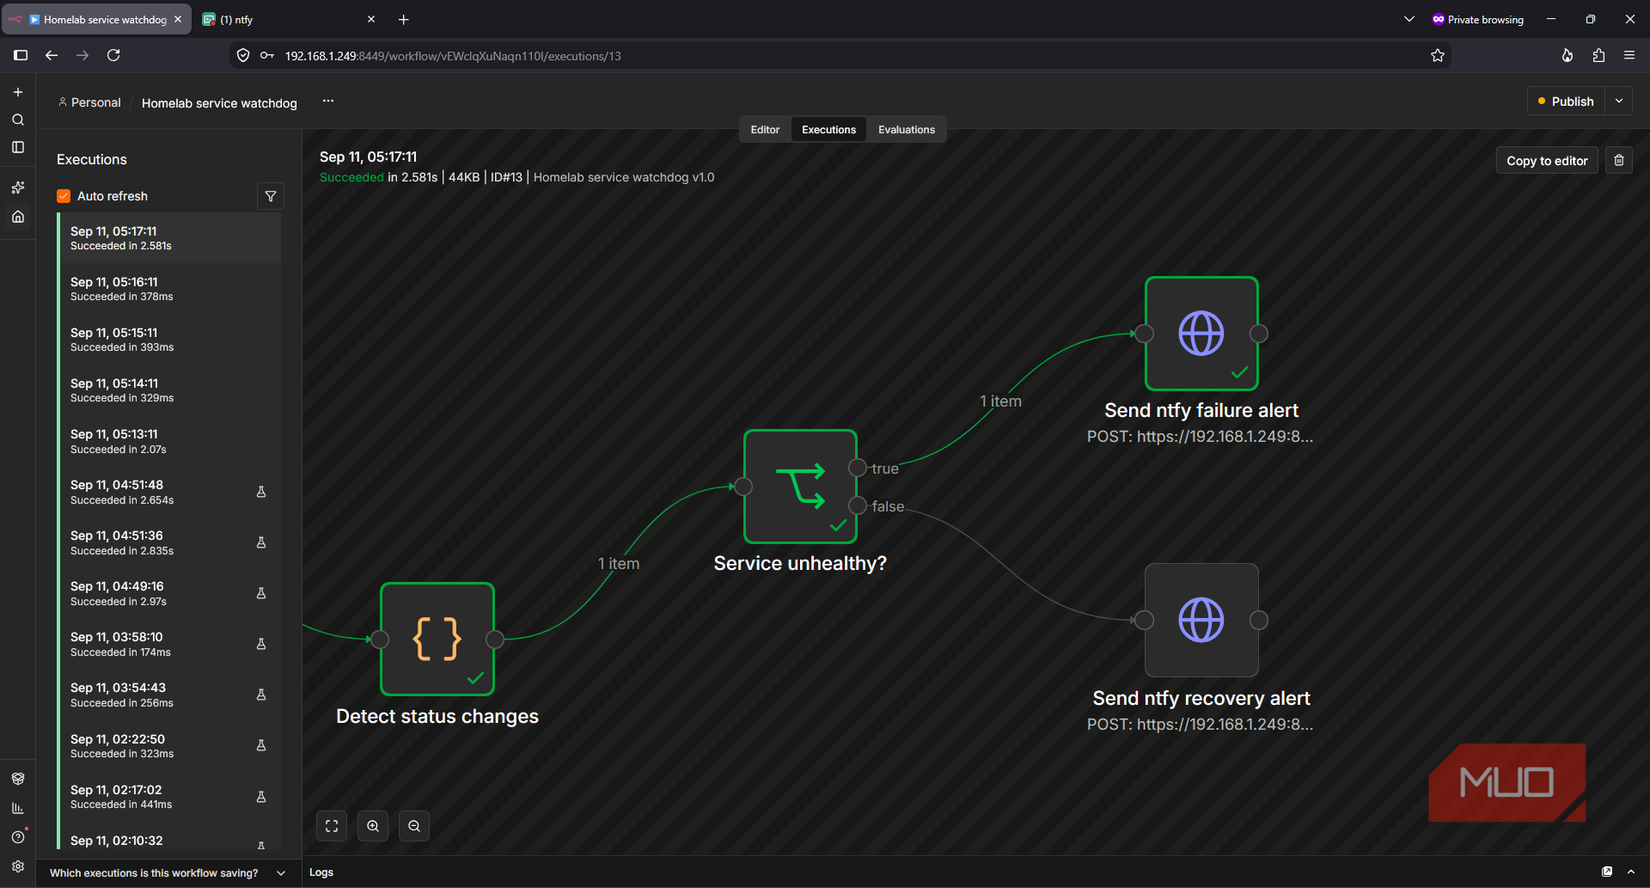
Пятиминутный цикл мониторинга был бы невыносимым без системы повторов и памяти состояний. Автоматизация начинается с узла Schedule Trigger, который запускается каждые пять минут. Первый Code-узел создает шесть элементов, каждый из которых содержит имя сервиса и URL для запроса. Такой подход упрощает добавление или удаление сервисов по сравнению с копированием HTTP-узлов:
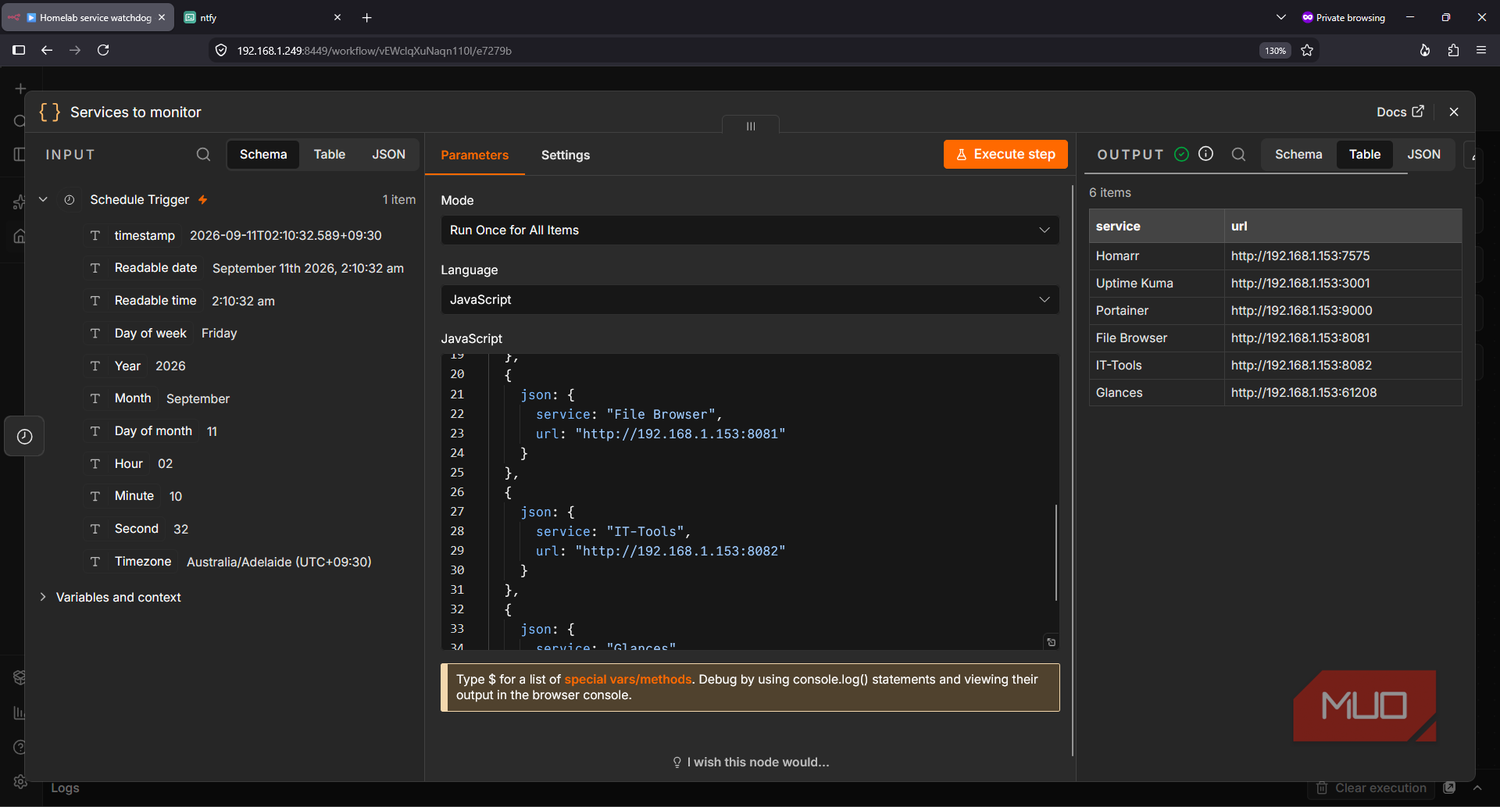
return [ { json: { service: «Homarr», url: «http://192.168.1.153:7575» } }, { json: { service: «Uptime Kuma», url: «http://192.168.1.153:3001» } }, { json: { service: «Portainer», url: «http://192.168.1.153:9000» } }, { json: { service: «File Browser», url: «http://192.168.1.153:8081» } }, { json: { service: «IT-Tools», url: «http://192.168.1.153:8082» } }, { json: { service: «Glances», url: «http://192.168.1.153:61208» } } ];
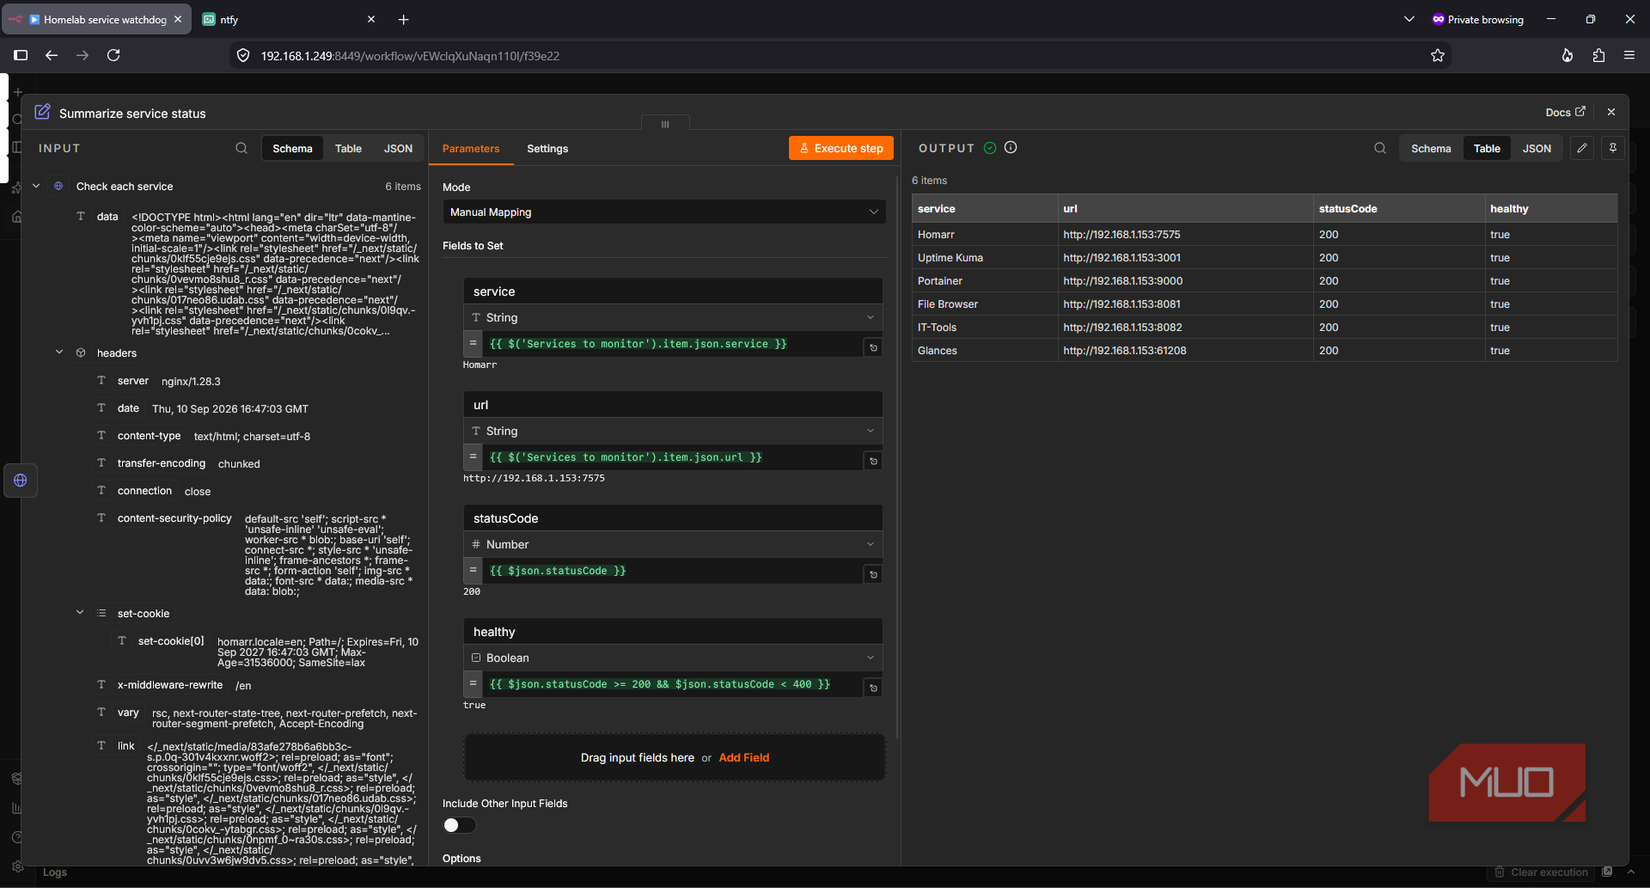
Затем n8n передает эти элементы через единственный узел HTTP Request. Для каждого запроса я задал: тайм-аут 5 секунд, две повторные попытки, следование редиректам и опцию Never Error. Последняя нужна, чтобы недоступный сервис превращался в данные, которые можно оценить, а не в ошибку, останавливающую выполнение. Так как на выходе получался большой объем HTML, узел Edit Fields очищает результат, оставляя имя сервиса, URL, статус и логическое значение isHealthy. Ответы в диапазоне 200–399 считаются «здоровыми», что позволяет корректно обрабатывать редиректы Uptime Kuma. Отказ в соединении возвращает статус 0, не прерывая воркфлоу.
Следующий Code-узел запоминает предыдущее состояние каждого сервиса. Он обновляет данные при каждой итерации, но выдает результат только в том случае, если статус изменился с up на down или наоборот:
const state = $getWorkflowStaticData(‘global’);
const changes = [];
for (const item of $input.all()) {
const currentState = item.json.healthy ? ‘up’ : ‘down’;
const previousState = state[item.json.service];
state[item.json.service] = currentState;
if (previousState !== undefined && previousState !== currentState) {
changes.push({ json: { …item.json, previousState, currentState } });
}
}
return changes;
Здесь я столкнулся с проблемой: первая схема отправки уведомлений в Telegram была подключена после ntfy. В результате бот получал ответ API от ntfy вместо данных о сервисе и сообщал, что «undefined не работает». Параллельное подключение обоих каналов решило проблему, став полезным уроком работы с визуальной автоматизацией.
Автоматизация мониторинга с помощью n8n
Платформа n8n от компании n8n GmbH (Берлин, Германия) представляет собой гибкое open-source решение для автоматизации рабочих процессов. Она позволяет визуально объединять приложения, API и модели ИИ для создания сложных многоэтапных сценариев с использованием кода или без него. Инструмент доступен через управляемый облачный сервис n8n Cloud или для самостоятельного развертывания с использованием Docker, npm или серверной установки. Разработчикам доступна бесплатная self-hosted версия Community edition.
Тестирование системы оповещений
Чтобы убедиться в работоспособности системы, я намеренно нарушил работу собственных сервисов. Первым шагом стала остановка контейнера Homarr командой docker stop homarr. Платформа n8n зафиксировала сбой во время следующего запланированного запуска: полученный объект содержал имя сервиса и URL, однако статус был равен 0, а параметр healthy имел значение false. Это подтвердило, что соединение действительно было разорвано, а не просто возвращена ошибка HTTP-страницы.
После фиксации сбоя workflow отправил срочное уведомление через мой self-hosted сервер ntfy и личного Telegram-бота. В течение пятиминутного цикла я не получал повторных сообщений, так как автоматизация запомнила статус «не работает» (down). Без этой функции одиночный сбойный контейнер мог бы переполнить ntfy и Telegram навязчивыми повторяющимися оповещениями. После запуска контейнера командой docker start homarr и подтверждения работоспособности через curl -sS -L -o /dev/null -w ‘HTTP %{http_code}\n’ http://192.168.1.153:7575, следующая итерация workflow зафиксировала восстановление и отправила одно сообщение о штатной работе в оба канала. Аналогичные тесты были проведены с контейнерами File Browser и IT-Tools, продемонстрировав идентичную последовательность сбоя, восстановления и уведомлений.
Создание ежедневного отчета о состоянии системы
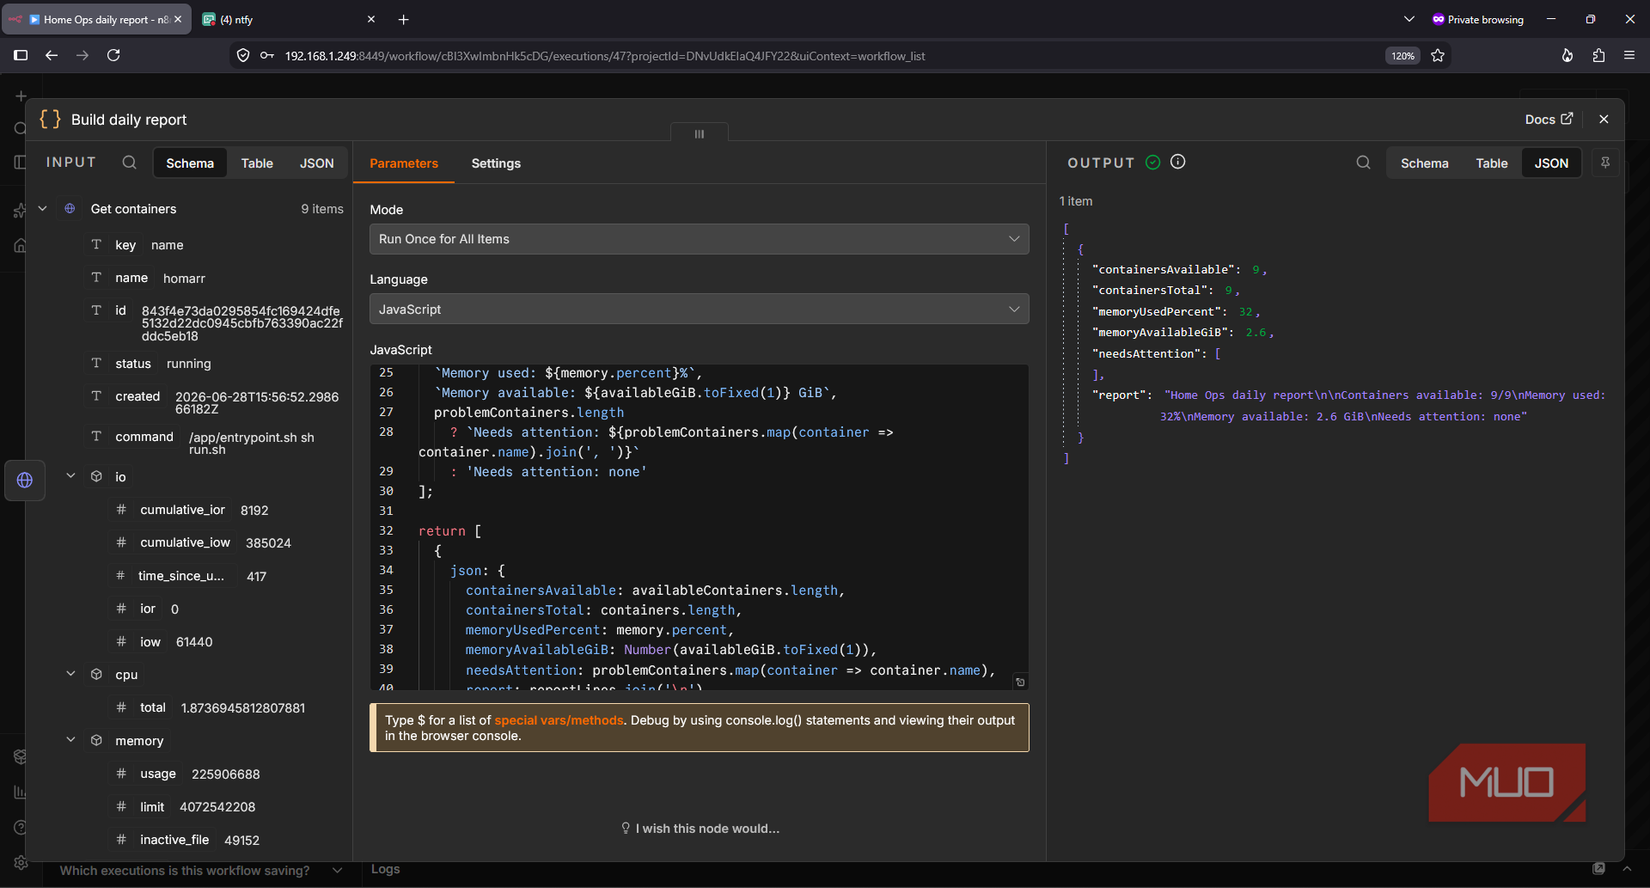
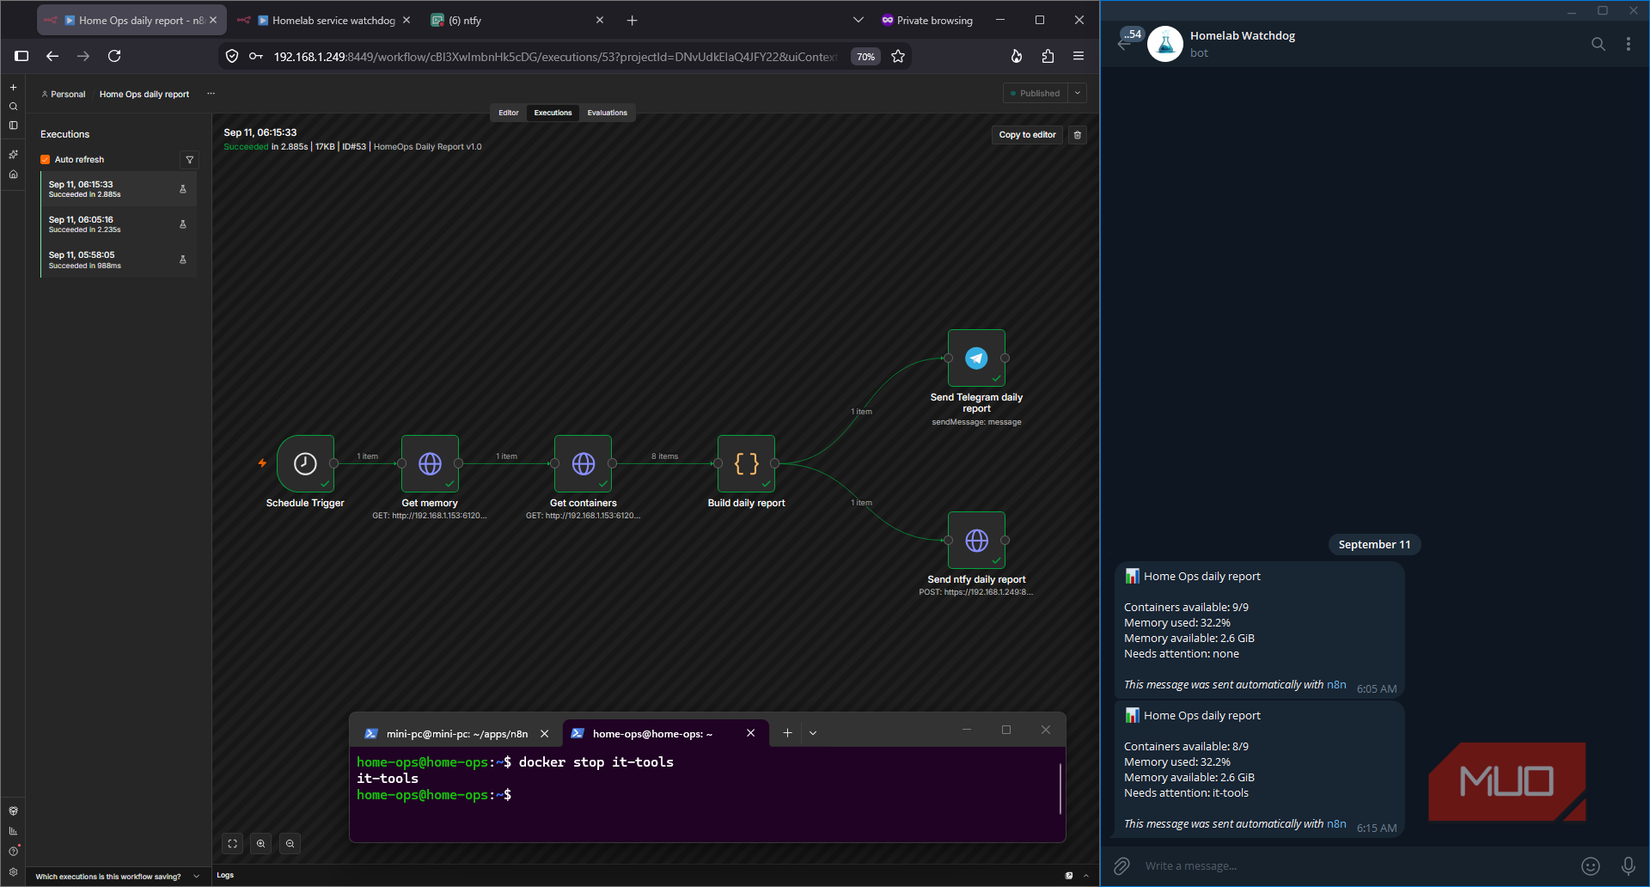
Помимо уведомлений об авариях, мне требовался ежедневный обзор состояния сервера и контейнеров. Для этого я создал второй workflow, запускаемый ежедневно в 8:00 утра (с учетом настроек часового пояса в n8n). Два узла HTTPS Request запрашивают данные Glances по адресам /api/4/mem и /api/4/containers, а узел Code объединяет их в отчет, содержащий количество запущенных контейнеров, потребление оперативной памяти, объем свободной памяти и список сервисов, требующих внимания.
При штатной работе система отрапортовала о 9 работающих контейнерах, использовании 32% памяти и наличии 2,6 ГиБ свободного пространства. Однако при разработке потребовалась коррекция алгоритма подсчета: Glances просто исключает остановленные контейнеры из ответа API, из-за чего количество «8 из 8» могло выглядеть как штатная работа, а не как отказ одного из девяти. Решением стало добавление фиксированного списка из девяти ожидаемых контейнеров для сравнения с ответом API:
const reportLines = [ ‘Home Ops daily report’, », `Containers available: ${availableNames.length}/${expectedContainerNames.length}`, `Memory used: ${memory.percent}%`, `Memory available: ${memory.availableGiB.toFixed(1)} GiB`, problemNames.length ? `Needs attention: ${problemNames.join(‘, ‘)}` : ‘Needs attention: none’ ];
Тест с остановкой IT-Tools подтвердил эффективность: отчет показал 8 из 9 доступных контейнеров с упоминанием IT-Tools в разделе «Needs attention». После перезапуска отчет вернулся к норме.
Перспективы развития автоматизации
Хотя Uptime Kuma проще в настройке и является моим первым выбором для мониторинга, n8n предлагает больше возможностей для дальнейшего развития. Настройка n8n сложнее: она требует Docker, управления учетными данными, очистки ответов API, отслеживания состояний и тщательной настройки связей. Ошибки при проектировании, например, порядок уведомлений, могут привести к сбоям в цепочке.
В текущем виде моя система повторяет запросы, подавляет дубликаты, распознает восстановление, отправляет уведомления по двум каналам и формирует утренний отчет. В будущем я планирую задействовать SSH-узел n8n для выполнения команд на удаленной машине, что позволит системе автоматически перезапускать контейнеры через Docker при возникновении сбоев и проверять эффективность предпринятых мер.
Почему n8n остается ключевым инструментом автоматизации
Возможность расширять систему и проводить дополнительные эксперименты — это главная причина, по которой я выбираю n8n в качестве уровня автоматизации, отдавая предпочтение ему, а не Uptime Kuma.
На текущий момент мой homelab сообщает о сбоях в режиме реального времени, однако в будущем он сможет предпринимать попытки первичного устранения неполадок еще до того, как я получу соответствующее уведомление.
Особенности реализации и обработки данных в n8n
Для обеспечения надежности мониторинга я уделил особое внимание настройке HTTP-запросов внутри n8n. Каждый запрос был сконфигурирован с учетом специфических параметров: тайм-аут ограничен 5 секундами, предусмотрены две попытки повторного выполнения (retries) и поддержка переадресаций (redirect following). Использование функции Never Error стало критически важным архитектурным решением: оно позволяет workflow превращать даже неудачные запросы в обрабатываемые данные, вместо того чтобы прерывать выполнение всей цепочки из-за ошибки соединения.
В процессе отладки я столкнулся с интересной особенностью: когда ответ сервера представляет собой массив HTML-кода, для чистоты данных необходимо использовать узел Edit Fields. Это позволяет извлечь только целевые переменные: имя сервиса, URL, статус и логическое значение isHealthy. При этом отказ в установлении соединения интерпретируется как статус «0», что позволяет системе продолжать работу и корректно логировать состояние сервиса, а не «замирать» на критической ошибке.
Особое внимание я уделил тому, чтобы монитор был полностью независим от целевого сервера. Если основной хост с сервисами (Home Ops) зависнет, мой «сторожевой» мини-ПК, работающий на IP 192.168.1.249, продолжит функционировать и отправлять уведомления. Это исключает ситуацию, когда уведомление об отказе системы не может быть доставлено, потому что сама система, ответственная за отправку, вышла из строя.
Уроки визуального программирования
Практический опыт показал, что визуальное соединение узлов требует точности. В начале работы я допустил ошибку, разместив узел отправки уведомлений в Telegram после узла ntfy. В итоге Telegram-бот пытался обработать ответ API от ntfy вместо данных о сервисе, что приводило к сообщениям вида «undefined is DOWN». Перестройка логики на параллельное подключение обоих каналов не только решила проблему, но и стала важным уроком в понимании того, как потоки данных (data streams) передаются между блоками в визуальных инструментах автоматизации.
Потенциал для самовосстановления системы
Хотя текущая настройка фокусируется на оповещениях, архитектура n8n закладывает фундамент для полноценной системы самовосстановления. В частности, использование SSH-узла n8n открывает возможности для удаленного выполнения команд на сервере. В ближайших планах — настроить автоматическую отправку команды docker restart при обнаружении сбоя в работе конкретного контейнера. Это позволит системе не просто сообщать о проблеме, а предпринимать попытку «лечения» (mitigation) еще до того, как я прочитаю уведомление в Telegram.